
DeepDojo.AI发布 2026-11-14English
Claude Code 一次改太多文件怎么办
在终端里扔一句“帮我写个完整的语音转文字工具”,听起来挺痛快。Claude Code 也表现得极其卖力:眨眼间新建了十几个文件,顺手装上一串音视频处理依赖。
没过多久,终端跳出一行报错,你立刻陷入排查困境。是系统麦克风权限被拒了,音频采样率解码出了错,转写模型的权重文件下载断了,还是界面状态更新写岔了?几个环节的问题搅在一起,想找个干净的位置回退,都不知道该退到哪一步。
改动范围一旦收不住,通常是三个地方出了问题:
- 开工时:任务太大,没有拆到能单独检查结果的粒度;
- 执行时:让它“自动排查直到修好”,却没说什么算修好、什么时候该停;
- 收尾时:测试通过了,实现里却多出一堆和目标无关的抽象、文件和依赖。
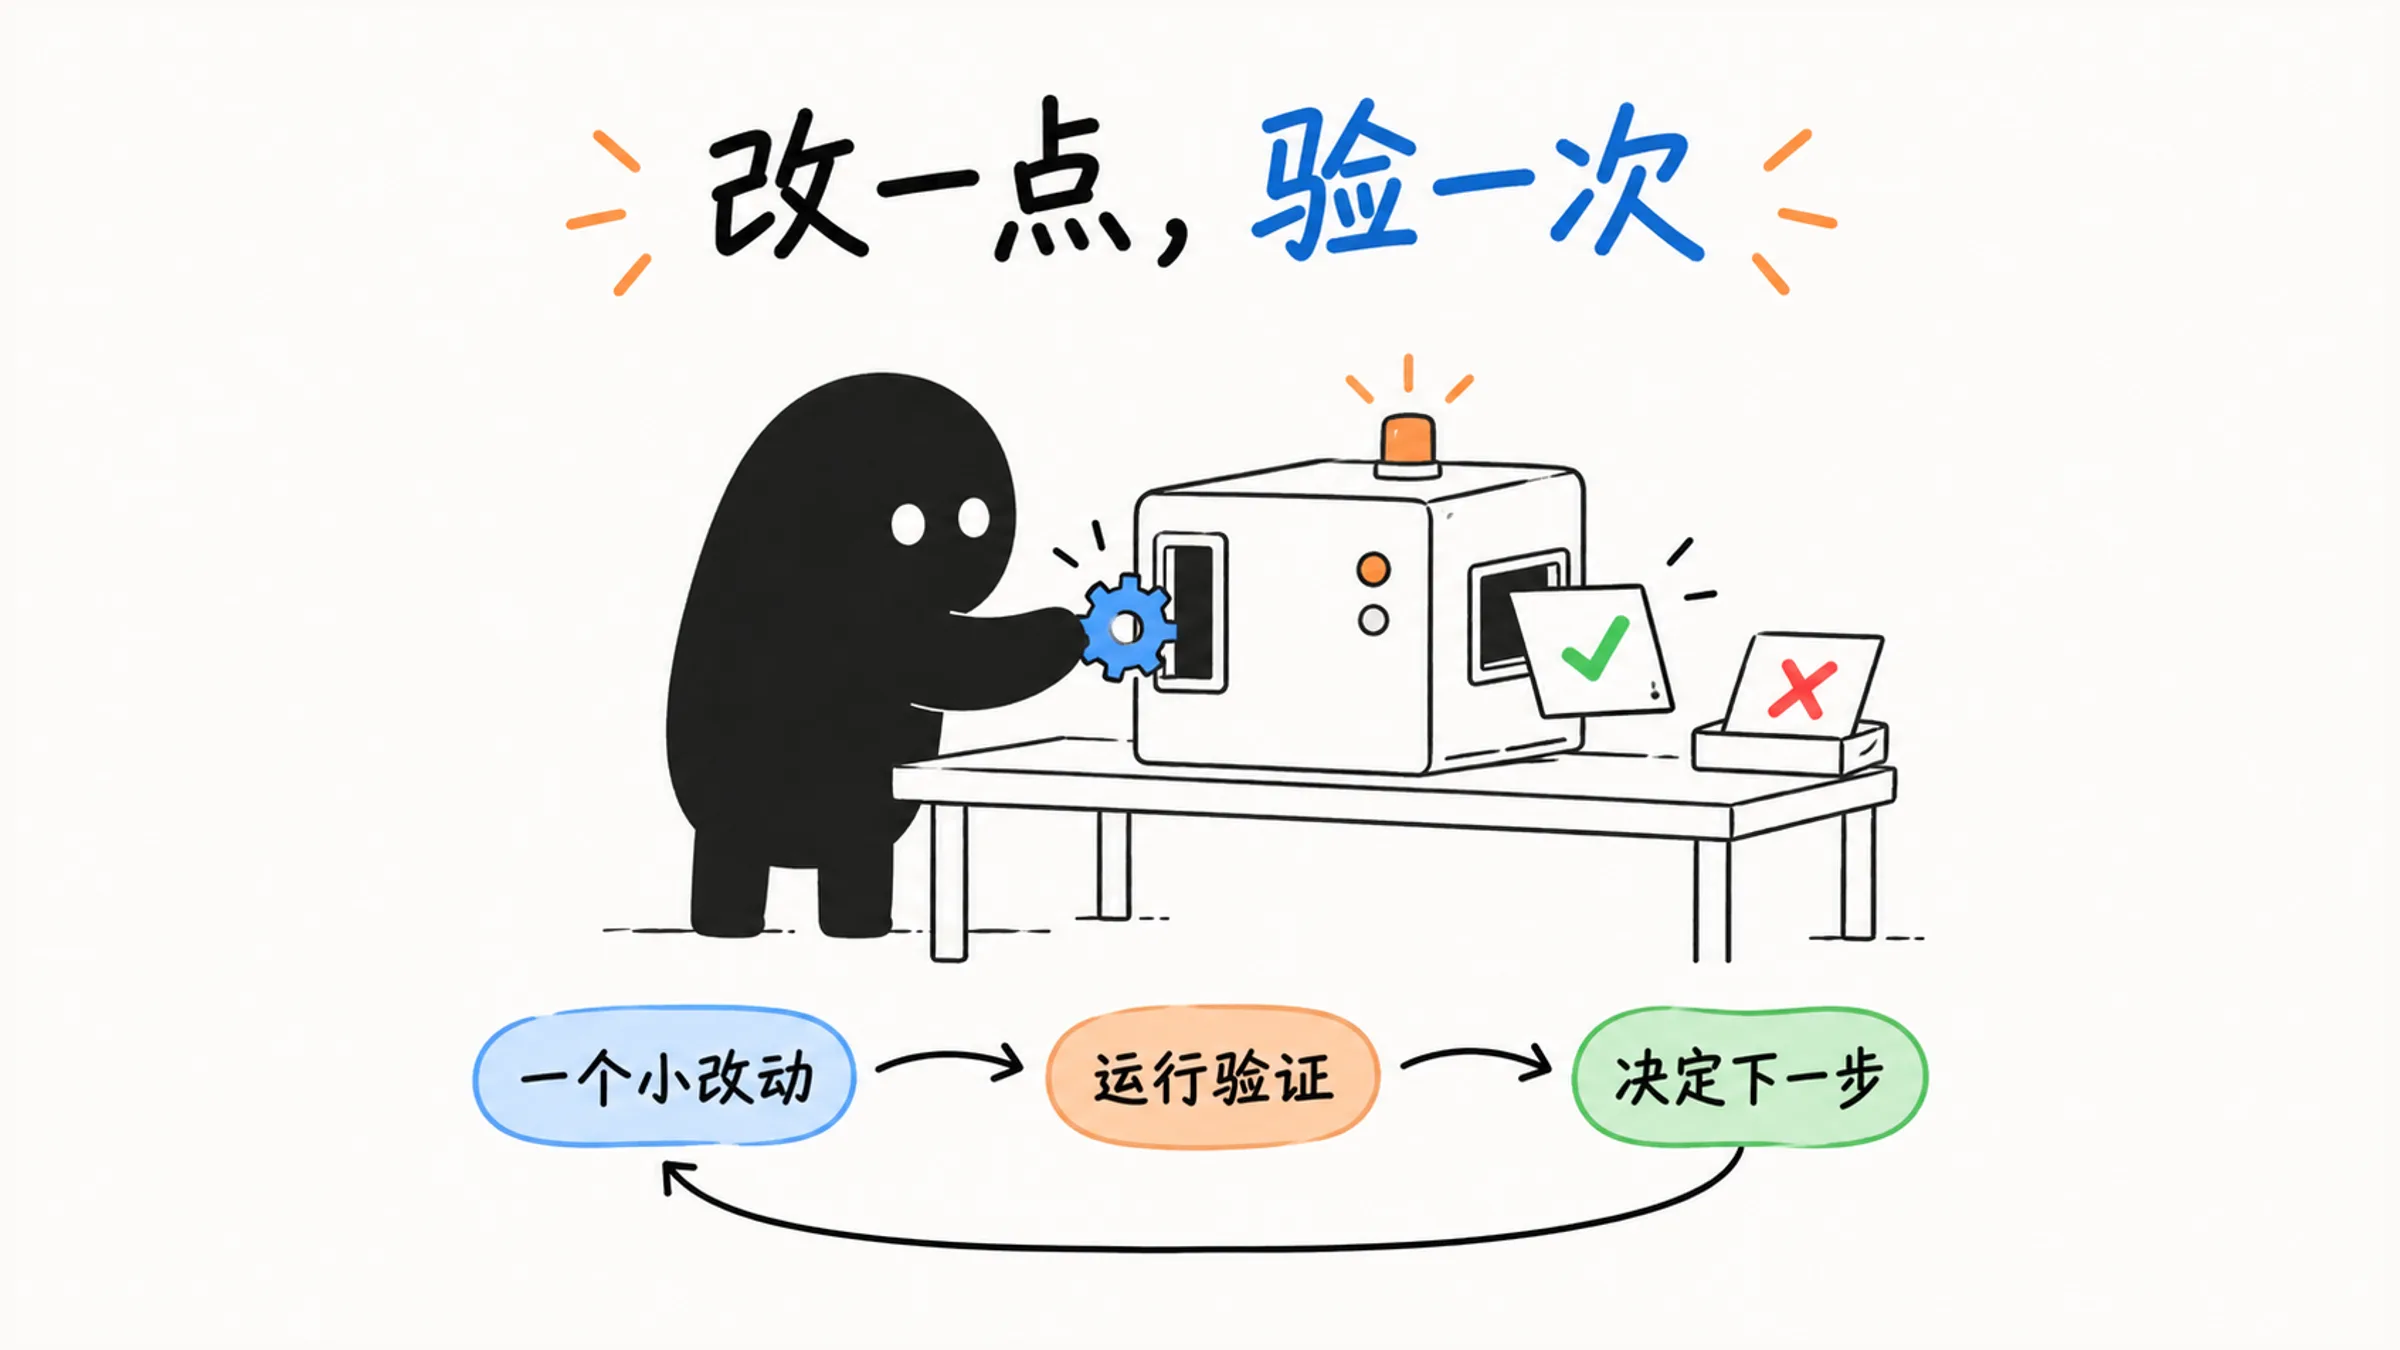
收住它的办法是一条循环:每次只做一小步,做完马上验证,再根据结果决定继续、修正、回退还是停止。落到三个源头上,就是开工时拆小,执行时写清成功和停止条件,收尾时做一次减法。
01 开工时:拆到能独立验收
一个任务只有在结果能被验证时才算完成:
理解问题 → 缩小范围 → 规划或验证假设 → 执行小步改动
    ↑                                         ↓
    └──────── 简化与修正 ← 检查证据 ←───────┘
最稳妥的做法,是把复杂任务拆成能独立检查结果的小任务:
完整应用
  ├─ 下载并加载模型
  ├─ 录制音频
  ├─ 把音频转成文字
  ├─ 将文字插入当前光标位置
  ├─ 整合界面
  └─ 打包并完成端到端测试
“把音频转成文字”还可以继续拆:
读取本地音频文件
  → 调用转写模型
  → 输出纯文本
  → 处理失败路径
  → 用样例音频验证
拆到“读取一段本地音频并输出转写文字”,就能先用样例音频检查结果,再处理界面和打包。比如用一句已知内容的录音核对转写文本,再用一个不存在的文件路径看错误提示是否看得懂:前者查成功路径,后者查失败路径。每一步再写清目标、涉及范围、验证方法和失败后的回退思路,出了问题才知道在哪一层。
拆的依据是结果能否独立验证,和步骤多少、文件多少关系不大。把转写拆成“写读取函数”“写模型调用代码”“写输出函数”,如果每项都只以“代码写完”为标准,就没法单独判断行为对不对。把它们合在一起,形成一个“输入音频、输出文字”的小任务,反而能验收。单个函数也能成为小任务,前提是写清输入、预期输出和检查方式。
文件多也未必难验收:批量修复同一种明确错误,可以用统一的检查和可审查的 diff 验收。反过来,只改一个文件却同时改变录音、转写和界面,反而说不清是哪项变化出了问题。
出现以下信号时,当前任务通常过大:
- 一次准备修改许多文件;
- 你无法预测下一步会发生什么;
- 找不到一个明确的测试或检查动作来验收结果。
这时可以直接要求 Claude Code 收紧任务:
这个任务范围过大。先不要写代码,请按可独立验收的结果拆成几个小任务,不要为了凑数量拆开相互依赖的步骤。
每个任务说明目标、涉及文件、验证方法和失败后的回退方式。
拆好之后,给每个小任务做一份计划。用 /plan 或 Shift+Tab 进入计划模式,让它先探索、后动手,计划里同时写明做什么与不做什么:不改哪些文件,不引入哪些依赖,哪些旁支留到以后,哪些动作必须等你确认。
先不要写代码。请探索当前项目结构,给出实现计划、涉及文件、风险点和验证步骤。
同时列出明确不处理的范围,以及需要我决定的问题。等我确认后再修改。
Claude Code 还能参与视频转 GIF、批量转写、CSV 分析、文件重命名、磁盘分析、PDF 转文字、媒体处理和 GitHub CLI 操作。任务类型变了,边界原则不变。涉及删除、覆盖、上传、安装或远端操作时,先调查影响,等你确认:
先调查,不要修改。
涉及删除、覆盖、上传、安装或推送远端时,先列出影响范围和恢复方式,等我确认。
02 执行时:每次改动后都拿证据
“自动排查直到修好”没有定义什么算成功、什么时候停。Claude Code 可能不断尝试,把原始问题和后续改动混在一起,越修越乱。
让它每次改动后都检查结果,再决定下一步:
提出假设
  → 做一个小改动
  → 运行验证命令
  → 读取结果
  → 判断继续、回退或停止
Claude Code 最佳实践文档把这一点说得很直白:给它一个能返回通过或失败的检查,它就能自己闭合这个循环;什么都不给,它只能凭“看起来做完了”停下,你就成了那个测试。
所以提示里要写出验证条件和停止条件:
请排查这个问题。每次只验证一个假设,并在修改后运行指定测试。
只有测试通过、输出符合预期且 diff 没有无关改动时才算完成。
连续三次尝试失败后停止,总结已验证的假设、结果和剩余不确定点。
这类闭环适合 git bisect、不稳定测试的排查、CI 修复、脚本样例验证和浏览器自动化。
交互式终端程序可以借助 tmux 变成能反复观察的环境:
tmux kill-session -t test-session 2>/dev/null
tmux new-session -d -s test-session
tmux send-keys -t test-session 'claude' Enter
sleep 2
tmux send-keys -t test-session '/context' Enter
sleep 1
tmux capture-pane -t test-session -p
test-session 是专用的测试会话,第一条命令先结束已有的同名会话;tmux 让进程保持运行,capture-pane 取回终端输出。中间的短暂等待只是给启动留时间,下一步仍要根据实际输出判断它是否就绪。
浏览器任务同样需要看得见的证据:
请用 Playwright 或 Chrome 调试工具打开页面。
优先读取可访问性树、DOM 状态和网络错误,坐标点击只作补充。
每一步先说明观察结果,再决定下一动作。
验证环境受限时,可以找能回答当前问题的替代证据:用 CI 的 Windows job 检查平台行为,用 draft PR 查看检查结果,用最小 demo 验证第三方库,或者用最小复现加 monkey patch 隔离依赖的行为。同时记下这种检查实际覆盖了什么,才知道还缺不缺真实环境里的验证。每一步要检查到多深,取决于出错的代价,AI 生成代码的四个检查等级专门讲这件事。
03 收尾时:删掉目标之外的东西
任务通过验证后,还要检查实现有没有超出目标。常见的过度实现包括:修改无关文件、为简单问题引入复杂抽象、添加多余配置、提前设计未来需求、引入不必要的依赖。
举个很常见的例子:需求只是“把一个列表里的邮箱地址按域名分组”,一段十行的遍历循环就能干净利落地搞定。AI 一转头却整出了策略模式接口、抽象提取器类、动态解析工厂,外加四五个互相引用的文件。测试全绿了,可接手维护的人哪怕只想看一眼核心逻辑,也得顺着四层继承关系来回跳。
这时要敢于追问这套设计的真实价值:这些抽象类在当前系统里被复用过哪怕一次吗?如果所有设计只是为了迎合“将来可能出现的扩展”,就把它们砍掉。代码是写给人维护的,用最直白、最扁平的代码解决当前问题,比留下一堆用不上的架构脚手架好维护得多。
让 Claude Code 先解释每处改动的必要性,再做删减:
请检查这次实现的复杂度,并列出:
1. 完成目标必需的改动。
2. 顺手加入但不影响目标的改动。
3. 可以删除或合并的抽象。
4. 不必要的依赖。
5. 更小的实现路径。
随后要求:
在行为和测试结果不变的前提下,删除无关改动,减少抽象和文件变更。简化同样适用于文档:删掉重复的总结,保留具体信息,让每段都承担清楚的作用。
04 每一轮结束前问三个问题
回看语音转文字工具的例子,每一轮结束前依次问自己:
- 这一轮是否只处理了约定的小任务?
- 样例音频是否验证了预期的行为,包括失败路径?
- 有没有加入与本轮无关的界面、文件或依赖?
三个问题都答得上来,才进入下一轮。任务跨了好几个会话时,已经验证过的路线和排除掉的方案也要跟着带过去,换会话时怎样保住之前的约定讲了交接时该写什么。
那个一口气生成十几个文件的工具,换成这种节奏重做,每一轮都只碰一小块,报错出现的那一刻,你就知道它在哪一层。