
DeepDojo.AI发布 2026-11-13更新 2026-11-13English
让多个 Claude Code 子代理安全并行
任务一多,很自然会想让几个 Claude Code 子代理同时开工:一个改订单接口,一个改库存逻辑,各干各的。为了不互相改坏文件,你给它们都配了 isolation: worktree,让每个代理在独立的工作树和分支上写代码。
跑集成测试时却出了怪事:测试数据时有时无,断言随机失败。查到最后才发现,两个代理连的是本机同一个 5432 端口上的 PostgreSQL,正在互相覆盖对方的测试数据。
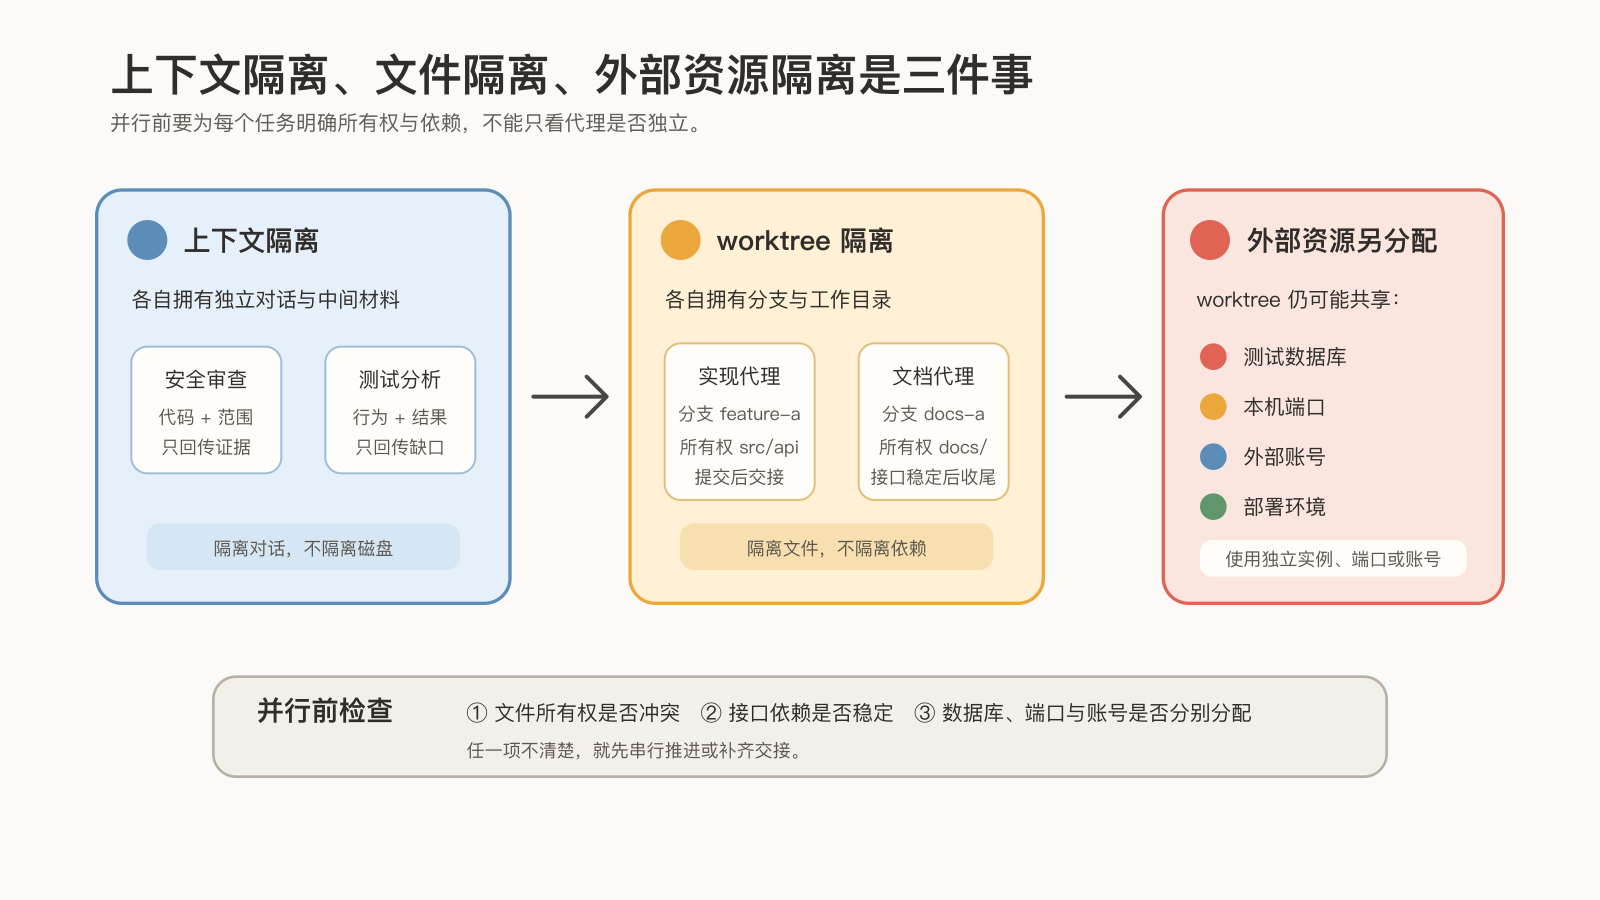
代码在目录上确实分开了,数据库、端口和远端资源却没有跟着分身。子代理的“隔离”其实有好几种,各管一段:
- 普通子代理只隔离对话上下文,让主会话不被专项分析的细节塞满;
isolation: worktree再隔离文件改动、分支和工作区状态;- 数据库、端口、测试令牌这些外部资源,没有任何一种设置会自动替你分开。
所以并行之前要画一张资源归属图:每个代理改哪些文件、用哪个数据库名和端口、共用哪些外部服务。还要找出依赖同一个未定决定的部分,比如接口参数还没定,测试和文档只能等。能并行的是已经明确的部分。
01 上下文隔离和 worktree 隔离
普通子代理只隔离对话上下文。按 Claude Code 的子代理文档,在定义里设 isolation: worktree,子代理会在一个临时的 git worktree 里运行,拿到一份独立的仓库副本,默认从你的默认分支切出,文件修改与主工作区分开。
---
name: feature-implementer
description: Implements features in an isolated git worktree.
tools: Read, Write, Edit, Bash, Grep, Glob
isolation: worktree
---
要区分两个概念:
| 概念 | 隔离内容 |
|---|---|
| 上下文隔离 | 对话、提示词、任务上下文 |
| worktree 隔离 | 文件改动、分支、工作区状态 |
Worktree 隔离适合高风险修改、并行实现、探索性重构,以及任何需要独立文件所有权的任务。独立 worktree 的工作可以按以下顺序收回:
- 子代理在独立分支与 worktree 修改并测试,返回分支、文件和检查结果。
- 主会话确认实际基线,检查分支已提交的 diff,以及 worktree 中尚未提交的变化。
- 审查通过后,将改动 merge 或 rebase 到主线。
- 合并后清理已完成的分支和 worktree。
隔离工作区减少了直接改坏主线的风险,但合并前仍需审查。
02 文件分开了,外部资源还在共用
看到 worktree 把文件隔开了,很多人就以为两个子代理可以放心并发跑起来。这时候退后一步想一想:
- 两个子代理跑集成测试时,是不是还在连本地同一个 5432 端口的 PostgreSQL?
- 前端启动 dev server 时,是不是都在抢 3000 端口?
- 调用的外部第三方服务,是不是共用同一个测试 token?
代码在目录上确实互不干扰了,网络端口、数据库状态和远端资源却没有自动跟着分身。
Git worktree 只负责代码文件这一块,其余外部资源,依然需要你像部署多实例一样,提前给它们分配好独立的数据库名、端口号或模拟器。并发启动前没画好这张资源归属图,两个代理很快就会在后台相互覆盖测试数据。
03 文件不重叠,接口依赖仍要排顺序
例如文档代理写 docs/api.md,实现代理写 src/api/,文件没有重叠,也仍有接口依赖:
接口约定已定 → 可先设计测试、整理文档结构
实现可用     → 再运行测试验证新行为
参数已确定   → 再补齐文档参数说明
这个例子里,两位代理没有改同一文件,依然不能各自猜一套参数。接口约定先稳定,测试和文档才能跟着落地。能并行的是已经明确的部分;依赖同一个未定决定的部分,仍需等待。
两个代理真的改到了同一个文件时,停止冲突写入,核对各自的 diff 后串行整合,其余没有冲突的独立工作可以继续。
04 后台运行要先约定交付
有些长任务适合后台执行,比如大型代码库扫描、长时间测试、大规模文档整理、多文件影响分析。官方文档说明,主会话派出的子代理默认就在后台启动;Claude 在等某个任务时,可以在终端里按 Ctrl+B 把它挪到后台,接着用 /tasks 查看进度。定义里写 background: true,则让这个子代理即使在 Claude 想等它时也留在后台。
---
name: long-researcher
description: Performs long-running research tasks in the background.
tools: Read, Grep, Bash
background: true
---
转入后台最大的好处是主会话不用干等,你能继续做别的。但挂到后台不等于任务已经完成。提前约定好它该交付什么文件、按什么标准验收,等它跑完时再切回来看结果。否则主会话一路往前推进,最后才发现后台交回来的产物根本没法用。
05 它需要继承讨论,还是重新判断
先列子任务缺哪些信息。普通子代理靠委派说明、角色提示和自己读到的文件工作,缺什么就补交接。
接着问:它需要沿用主会话的判断,还是重新检查?分叉当前对话(比如用 /subtask 派出一个继承完整对话的子代理)能延续已有讨论,继续架构取舍时有帮助;主会话里的错误假设也会一并过去。若要一份独立审查,就只交代码、目标和必要证据,让它重新形成判断。
注意三个不同概念:
| 机制 | 解决的问题 |
|---|---|
| 普通子代理的独立上下文 | 隔离专项分析,避免主会话塞满细节 |
| 分叉当前对话 | 延续已有讨论背景;是否可用与默认行为依版本和运行模式而定 |
Skill 的 context: fork | 把 Skill 放进子代理执行,子代理看不到之前的对话 |
看到 Skill 中的 context: fork,容易顺着名字推断它会复制完整历史。官方专门提醒过:尽管名字里有 fork,它并不在当前对话的分叉里运行,任务依赖历史时要改用分叉对话。代理究竟拿到了哪些前提,可以从委派信息和实际输出验证;缺什么,再补相应交接。
06 持久记忆和嵌套委派
memory 字段可以让子代理拥有自己的持久记忆范围:
| memory | 位置 | 适合场景 |
|---|---|---|
user | ~/.claude/agent-memory/<name>/ | 个人跨项目记忆 |
project | .claude/agent-memory/<name>/ | 团队共享项目知识 |
local | .claude/agent-memory-local/<name>/ | 本地项目知识,不提交 |
选择方式与普通 Memory 相同:团队共享知识放 project,个人习惯放 user,本机实验放 local。持久记忆会影响后续行为,因此只保存稳定、可靠且与职责相关的信息。
子代理若有 Agent 工具,可以继续委派。下面的类型白名单有更窄的适用条件:
---
name: coordinator
description: Coordinates work between specialized agents.
tools: Agent(worker, researcher), Read, Bash
---
按官方文档,这个白名单在该定义通过 claude --agent coordinator 作为主会话运行时,限制它能派出的子代理类型。把它交给普通子代理时,先确认运行方式,才能判断这项写法的作用。任务结束于当前代理时,移除 Agent;需要继续委派时,划定范围、层级和交付,避免一层层重复同一项工作。
07 插件里的子代理与 Agent Teams
插件可以分发子代理,但要特别注意权限、工具范围和边界条件。官方说明,出于安全考虑,插件里的子代理会忽略 hooks、mcpServers 和 permissionMode 这三个字段,防止插件安装后隐式获得过高的控制权。启用带代理的插件前,检查三项内容:
- 工具:Bash、Write 等能力是否与职责相符,是否需要限制。
- 提示正文:是否包含访问网络、发送数据或修改配置等超出描述的步骤。
- 凭据:要求的 token 或环境变量是否只覆盖必要功能。
这些内容检查过,仍不清楚某一步会做什么,就先在受控的一次性任务中观察,核对它实际读写和调用的范围,再决定是否留作日常角色。
Agent Teams 是更高级的协作模式,适合多个角色围绕同一个复杂任务协作:
| 维度 | Subagents | Agent Teams |
|---|---|---|
| 重点 | 委派单个专业任务 | 多角色协作 |
| 复杂度 | 较低 | 较高 |
| 协调方式 | 主代理委派和汇总 | 团队式任务分配与消息流 |
| 风险 | 上下文和权限管理 | 协调成本、重复工作、状态复杂 |
先拿一两个边界清楚的子代理跑一条实际任务。若主代理委派、收回结果就够,就保留这个组织方式。只有角色之间确实需要同时协作、互相汇报,才考虑 Agent Teams。
委派说明和交接格式怎么写,见怎么给 Claude Code 子代理布置任务。子代理在独立 worktree 里的改动,Rewind 一般恢复不了,要靠 Git 收回,检查点和 Git 的分工见Claude Code 回退了代码,数据库却没回去。
并行开工前花几分钟画一张表:每个代理改哪些文件、用哪个库名和端口、等哪个接口定下来。有了这张表,几个代理才不会互相踩到对方的数据。