
DeepDojo.AI发布 2026-11-13更新 2026-11-13English
Claude Code 回退了代码,数据库却没回去
Claude Code 有一个让人很安心的功能:改坏了可以回退。连按两次 Esc 打开 Rewind,选一个之前的节点,刚才的代码编辑就撤销了。
很多人因此放开手脚试方案,直到某次回退之后,发现事情没那么简单。那次你在排查一个缓存问题:先让 Claude Code 改了两处业务代码,又在终端里用 psql 建了三张临时测试表,最后执行 pnpm install 装了个调试库。
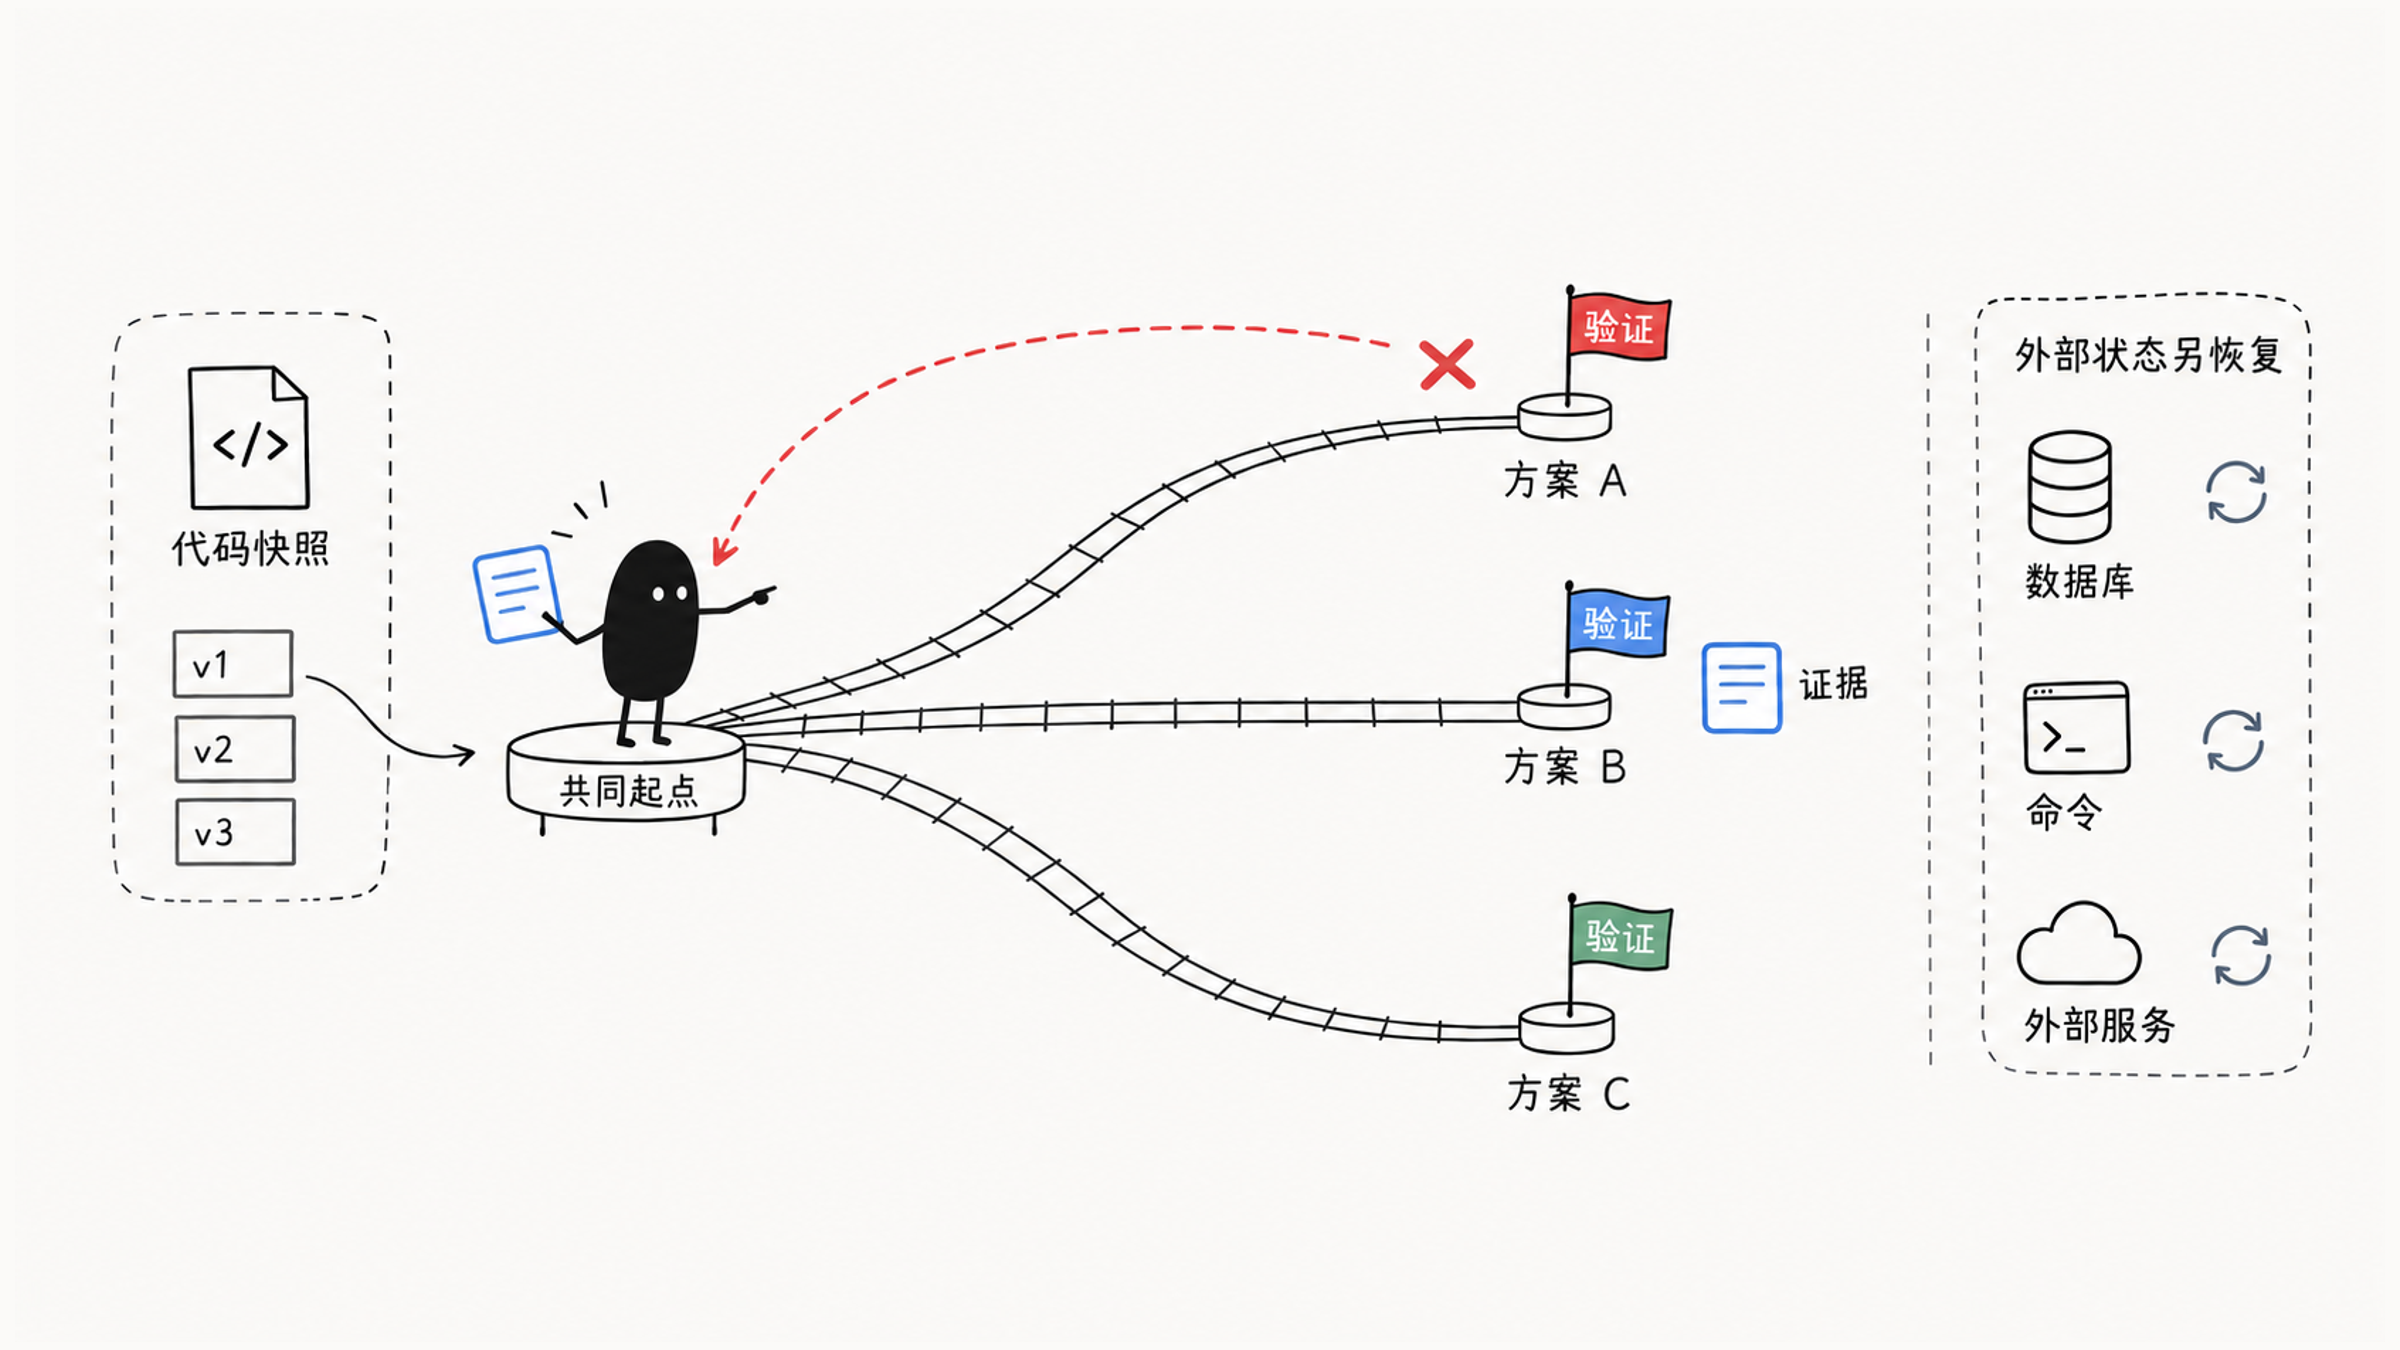
方案失败,你用 Rewind 撤回了所有代码编辑,准备换一种思路。可数据库里的测试表还在,node_modules 里的依赖也已经变了。代码回到了起点,实验环境却没有。
面对重构、迁移或性能优化,我们常在两种心态之间摇摆:
- 一种是畏手畏脚,每次只敢碰一两行边缘逻辑,生怕改崩了整个工程;
- 另一种是顺着灵感连续改十几个文件,直到报错一大片,才发现干净可用的起点已经找不回来了。
检查点(Checkpoint)给这种试错留了一条退路。用好它的关键有两条:先分清它能恢复什么、恢复不了什么,再给每次实验定好共同起点,让几个方案的比较结果真正有依据。
01 检查点、回退和实验起点
先分清三个概念:
| 概念 | 含义 | 适合场景 |
|---|---|---|
| Checkpoint | 与会话消息关联的恢复点,保存被跟踪文件的编辑前状态 | 开始新一轮任务、方案切换前 |
| Rewind | 回到某个 checkpoint,并按选项恢复对话或代码 | 方案失败、误改文件、想回到干净状态 |
| Branch Point | 比较方案时共同采用的起点,是实验设计中的概念 | 比较缓存方案、数据库设计、UI 布局 |
Checkpoint 是保存点,Rewind 是恢复动作,Branch Point 是你选定的共同起点。后者不代表系统自动保留每条实验路线;需要长期保留多个实现时,用 Git 分支或提交保存。
02 按改动来源分清恢复范围
检查点不是整台机器的时光机。按 Claude Code 的 Checkpointing 文档,它跟踪的是 Claude 用文件编辑工具做的改动:
| 改了什么 | 怎样恢复 |
|---|---|
| 主会话用文件编辑工具改的文件 | 可选 Rewind 恢复代码 |
| 只被 Bash 命令改过的文件、多数子代理或其他会话改的文件 | 另备 Git、补丁等文件恢复办法 |
| 数据库和外部服务,包括已发消息 | 对应备份或补偿操作 |
官方文档还提到一个细节:一个文件只要被 Claude 的编辑工具改过,之后 Bash 再改它,Rewind 也会一起撤销;从头到尾只被 Bash 改过的文件不在跟踪范围内,要靠 Git 之类的版本控制恢复。
把这张表代入开头的实验:Rewind 撤回了两处代码编辑,psql 建的三张表和 pnpm install 带来的依赖变化都还在。所以每当准备开展一场实验,动手前先把可能被污染的环境盘算清楚:
- 数据库状态;
- 本地环境变量;
- 锁文件变更;
- 对外发送的网络消息。
针对每一项提前备好恢复脚本,或者干脆放到随时能删掉重建的沙盒容器里跑。回退代码只是恢复实验状态的第一步,上一轮留下的脏数据也可能影响下一轮验证。
03 打开回退点并选择范围
打开回退点有两种方法。最快的是在输入框为空时连按两次 Esc,唤出回退菜单;也可以输入 /rewind,它的别名有 /checkpoint 和 /undo。菜单里按顺序列出你在这次会话里发过的每条提示。
打开列表后,先想清自己想保留什么,再找对应状态。查看附近改过的文件和对话进度,确认它是不是实验开始前的那一刻。时间最近的点,可能已经包含出错修改;较早的点,也可能撤掉了你想保留的讨论。
回退时先判断问题发生在代码、对话还是两者,然后选择对应范围:
| 选项 | 会恢复什么 | 适合场景 |
|---|---|---|
| 恢复代码和对话 | 被跟踪的文件编辑和对话回到所选点 | 方案整体失败,想从旧起点重新开始 |
| 恢复对话 | 只回退消息,保留当前代码 | 对话方向错了,但代码还想保留 |
| 恢复代码 | 只回退被跟踪的文件修改,保留对话历史 | 文件被改坏了,但讨论过程仍有价值 |
| 从这里开始总结 | 把这一点之后的对话压缩成摘要 | 对话太长,想保留结论并减少上下文压力 |
| 取消 | 不做恢复 | 只是查看,不确定是否回退 |
面对这些选项,先问自己:刚才的尝试中,还有哪些内容值得保留?
- 如果刚才的追问已经把业务边界和算法细节盘明白了,只是最后两段代码写得漏洞百出,就选“只恢复代码”,把那段分析讨论完整留下来。
- 如果代码大体可用,只是中间扯了一大堆无关内容把上下文撑满了,就“只回退对话”。
- 要是整条路线从头到尾全想歪了,就把代码和对话一起恢复到原来的起点。
如果所选的那一点之后没有被跟踪的文件写入,菜单里不会出现两个恢复代码的选项。选完回退之后,习惯性地打个 git diff 扫一眼,确认回到手里的代码确实是那个干净的基线。
04 自动建点与保留期限
Claude Code 会在你发出每条开启新一轮处理的提示时自动建立检查点。处理过程中追加的消息不一定形成独立恢复点,因此以 /rewind 列表为准。
恢复会话后仍可使用保留的检查点,但文件快照有数量和清理周期限制:官方说明一次会话保留最近 100 个检查点的快照,默认大约 30 天后清理。需要长期保留的起点和结果,及时存进 Git,别依赖默认保留时长。
开始大改动前,先确认当前 diff 和工作区里已有的用户修改,再确定实验起点。检查点不是“清空一切改动”的按钮。
05 比较两个方案前,先保存方案 A
检查点最典型的用法是探索不同方案:
从干净状态开始
  |
  v
尝试方案 A
  |
  v
回退到起点
  |
  v
尝试方案 B
  |
  v
比较 A 和 B
比如给 API 加缓存,先试 Redis,再试内存缓存。准备离开 Redis 方案时,先保存实现和测试结果,之后才能比较。恢复起点以后,还要查 Redis 中留下的缓存。输入、负载、初始数据相同,外部缓存也已清理或隔离,第二次实验才有可比依据。
离开 A 前,把实现和检查结果保存好:
| 保存方式 | 需要补查什么 |
|---|---|
| Git 提交 | 只包含已暂存、纳入版本管理的文件;数据库、未跟踪文件和对话另存 |
git diff > /tmp/plan-a.patch | 默认只含未暂存的已跟踪变化;先看 git status,另存已暂存内容与新文件 |
| 实验笔记 | 只能记录结论,不能恢复实现 |
临时提交可放独立分支,验证后再整理入团队历史。确认所需文件和外部状态都能找回,再换方案。
06 几种典型的比较场景
安全重构。把重构拆成几步,每完成一小段就运行测试。通过就继续;失败且问题很可能来自最近几步,就回退到上个稳定点,迅速清除错误改动。
错误恢复。比如 Claude Code 重构认证模块后破坏了 OAuth 集成。先回到重构前的稳定状态,再换一种更稳妥的方案,避免补丁叠加。
数据库迁移。假设你要在可重置的测试环境中比较“直接迁移”和“渐进双写”两种方案。这里比较迁移代码与测试结果,不在生产数据上反复试错:
1. 先说明目标:比较直接迁移和双写迁移。
2. 从当前状态开始,让 Claude Code 实现直接迁移。
3. 运行测试,保存方案代码、失败点和风险。
4. 恢复被跟踪的代码,并单独重置测试数据库到相同基线。
5. 让 Claude Code 实现双写迁移。
6. 再次运行测试。
7. 比较两种方案的代码复杂度、风险、测试结果和回滚成本。
两条路线都测完,再回到迁移要解决的问题。数据是否一致?失败能否重试?还可不可以切回旧系统?双写多了两边不同步的可能,一轮测试通过还不能回答这些问题。把代码复杂度、风险、结果和恢复成本放在一起比较,选定后用 Git 留实现,数据库恢复步骤另存。
性能优化。做性能优化时,先确认实验能否重来,再比较快了多少。下面是假设数据:当前 API 平均响应时间是 450ms,比较 Redis 缓存、查询优化、响应压缩三种方式。
Baseline:450ms
  |
  |-- Redis 缓存:280ms
  |
  |-- 查询优化:180ms
  |
  |-- 响应压缩:320ms
看起来查询优化最好。可如果测查询优化时缓存已经热了、连接池也建好了,这个结果就同时受到了环境变化的影响。让每个方案回到相同起点,再使用同一负载、数据、预热轮次和并发,多测几次,才更有依据把变化归因于实现。
如果查询优化确实效果最好,可以恢复事先保存的对应 Git 提交或补丁,再在此基础上添加缓存。更值得保留的是条件清楚、能重复测到的改善,一次漂亮的数字还不够。
界面设计。重设计仪表板时,可以从同一起点分别试侧边栏、顶部导航和卡片网格,用截图检查拥挤程度与信息分组。每条路线都保存截图和代码,再回退起点。如果卡片网格更好、顶部导航也值得保留,就恢复已保存的网格版本,再加入顶部导航。组合的是经过检查的设计,避免在混乱的实验状态上继续修补。
调试假设。假设应用存在内存泄漏,你有几个猜测:事件监听器没有清理、数据库连接池没有释放、缓存长期持有已不再使用的对象。沿着多个猜测一路修改,最后很难判断哪个改动有效。让每个假设都从同一起点接受验证:
Before debugging
  |
  |-- 假设 1:修事件监听器
  |     |-- 内存分析仍失败
  |
  |-- Rewind
  |
  |-- 假设 2:修数据库连接池
  |     |-- 内存分析仍失败
  |
  |-- Rewind
  |
  |-- 假设 3:检查缓存对象未释放
        |-- 内存泄漏修复
“修复”需要怎样的依据?每次用同一请求过程观察内存是否还持续增长。还有一个容易漏的起点:代码回去了,运行中的进程可能仍留着上一轮的缓存对象。重启测试进程,采用相同请求数量和观测时间,再比较。先核对代码恢复,再核对条件恢复,两项都成立才继续试下一个假设。
API 设计、配置迁移、测试策略也可以这样比较。例如比较 REST 与 GraphQL,先用 Git 保存 REST 实现,再用 Rewind 恢复起点,两条路线用同一组接口需求和测试。配置迁移涉及的环境变量、密钥和部署状态,检查点撤不回,要在对应环境恢复。
07 长时间调试后整理对话
长时间调试会积累大量上下文。尝试过多个方案后,失败过程和有效发现混在一起,后续就更难判断该依据哪些信息。
回退菜单里的“从这里开始总结”适合这种情况。它把某个点之后的对话压缩成摘要,原始消息仍留在会话记录里,当前可见的上下文则变轻。使用时可以额外指定摘要关注点:
请重点保留:
1. 我们尝试过哪些方案。
2. 哪些方案失败了,为什么失败。
3. 哪个方案目前最有效。
4. 接下来应该继续做什么。
这个选项保留调试结论,并在进入下一阶段前精简上下文。它只管理长对话,不会回退代码。
08 检查点和 Git 怎样分工
Checkpoints 和 Git 都能帮助你回退,但边界不同:
| 工具 | 适合做什么 | 不适合做什么 |
|---|---|---|
| Checkpoints | 会话内试错、探索、撤回最近方案、比较多个路线 | 长期保存正式代码历史 |
| Git | 保存可审计的代码历史、团队协作、发布和回滚 | 频繁保存每一次对话试探 |
什么时候转到 Git?看这份状态以后还要不要用。检查点受数量和清理周期限制,几周后未必还在;准备长期保留的代码就及时提交。探索过程中可以先存独立分支或 WIP,找到可接受方案,再清理代码和测试,整理入团队历史。
失败方案上的补丁不断累积,会使恢复和排错更困难。当修复补丁比原业务逻辑更复杂时,可以回到干净的起点,再调整方案。出现下面这些信号时,就该考虑回退:
- 当前方案越来越复杂,且你还没有确定方向。
- 测试刚失败,问题很可能来自最近一两步。
- 你想比较两种实现方式。
- 你发现 Claude Code 修改了不该动的文件。
- 对话已经偏离目标,继续解释比回到旧节点更费力。
回退前先确认三件事:这个 checkpoint 是否就是你想回到的状态;你要恢复代码、恢复对话,还是两者都恢复;当前状态里有没有需要先记录下来的发现。
遇到故障时,可以按这条路径排查:
找不到 checkpoint → 查当前会话、独立轮次、快照是否保留
有消息但没代码恢复项 → 查修改是否来自可跟踪的文件编辑工具
选中后恢复失败 → 查检查点是否有效,再查文件系统和权限
检查点在整套能力里的位置,可以回看 Claude Code 功能这么多,先学哪几个 里的四层路径。一次改动跨越文件、命令和数据库好几个阶段时,每段怎样记录恢复办法,见 团队 Claude Code 配置从一个命令搭起。
下一次准备试第二个方案前,先问两句:代码回到起点了吗?数据库、依赖和外部状态也回去了吗?两句都答得上来,比较结果才算数。