
DeepDojo.AI发布 2026-11-13更新 2026-11-13English
把太长的 SKILL.md 拆成几个文件
Skill 刚写出来时通常很短,一个 SKILL.md、几十行流程就够用。用得越久,往里加的东西越多:安全清单、测试清单、性能清单、报告模板。
到第三版,团队的代码审查 Skill 已经有 260 行。这次你只想查一处鉴权改动,Claude 每次触发都要把这 260 行一起读进来,真正用得上的只有核心流程、安全清单和报告模板,大约 150 行。
材料越堆越多,主线反而被淹没。整理 Skill 的文件,难点往往不在写法,而在三个判断:
- 这项工作值不值得写成 Skill,还是一条命令就够;
- 哪些内容放进
SKILL.md,哪些放进支持文件; - 支持文件什么时候读,哪些依据必须一开始就读到。
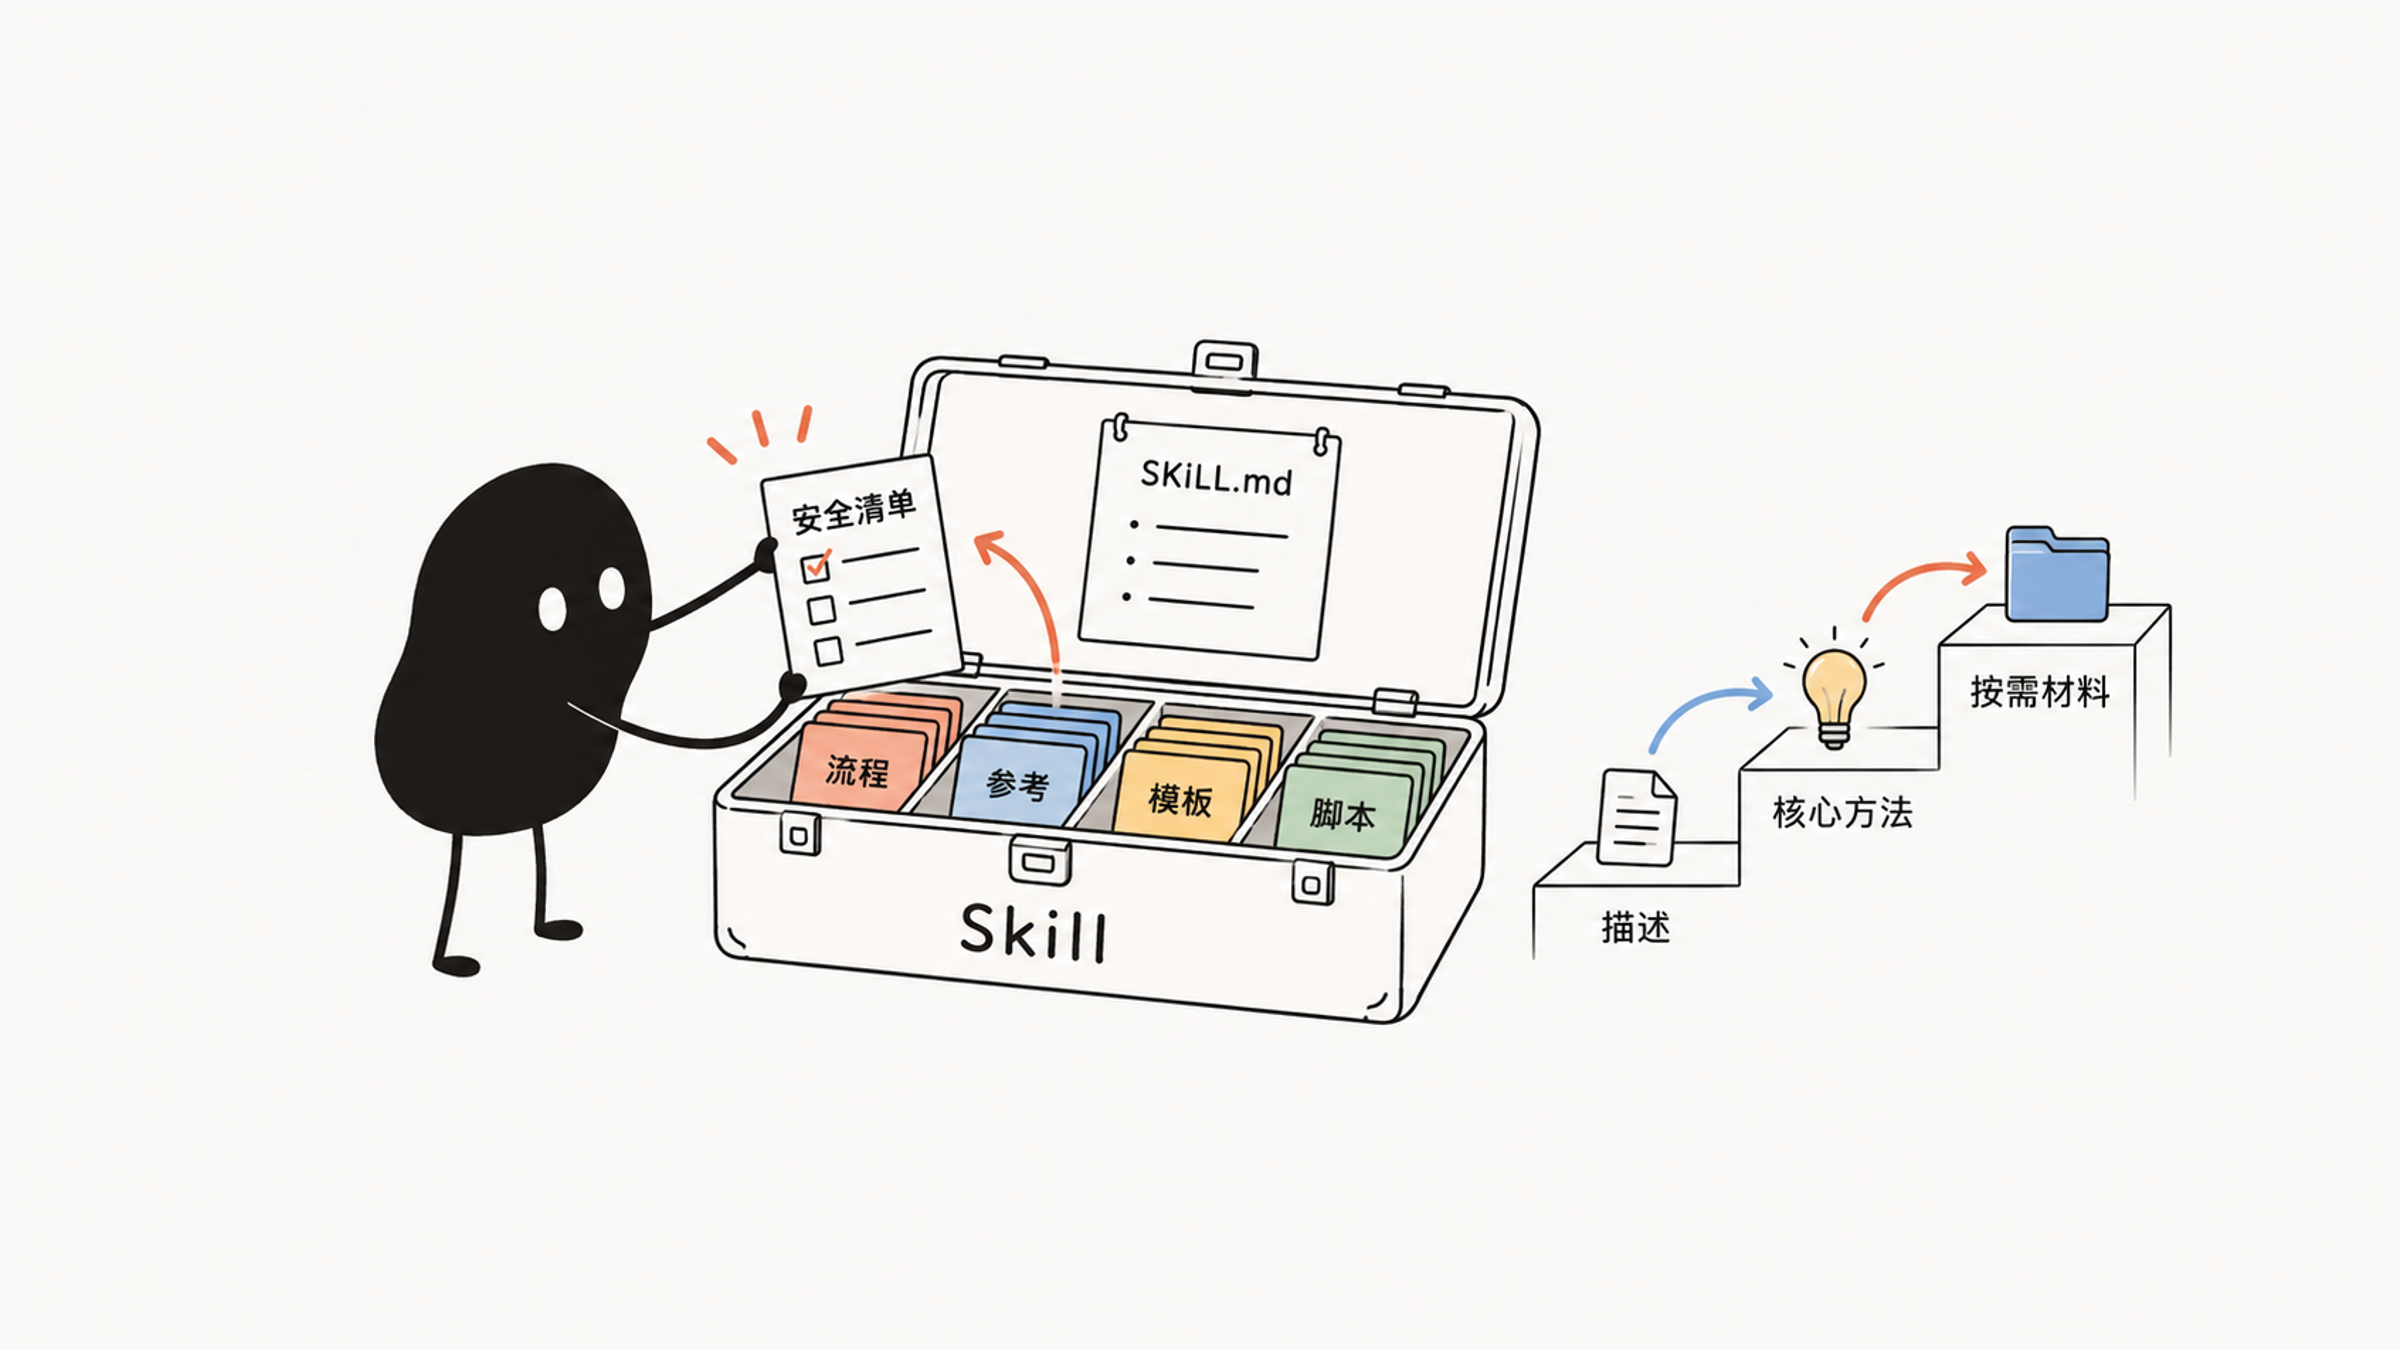
Claude Code 本身就按层加载 Skill:先看名称和描述,触发后才读 SKILL.md,支持文件在真正需要时才打开。顺着这个机制组织文件,就能让主文件只写方法和调度,长资料按条件读取,判断依据又不会被一并省掉。
01 什么时候值得写成 Skill
很多时候我们容易把概念搞混:Slash Command 解决的是“怎么快捷地启动一项任务”,Skill 解决的是“这项专业工作该遵循怎样的步骤和方法”。它们完全可以共用同一套底座。
像“提炼当前 git diff”“拟一个规范的提交说明”这种一分钟内能搞定的短流程,单写一个包含核心提示词的 SKILL.md 就能直接当命令用了。如果这项工作要求先翻阅排查手册、对照内部规范核验、套用特定报告模板,甚至调用本地脚本,再把它扩充成一个完整的能力包。
面对手头一堆想要提效的工作,可以顺着下面这张清单快速分流:
| 判断问题 | 更适合的做法 |
|---|---|
| 只是固定一句提示词或一个短流程吗? | Slash Command |
| 需要一整套方法、模板和参考资料吗? | Skill |
| 需要在工具调用前后自动执行检查吗? | Hook |
| 需要把任务交给隔离角色处理吗? | Subagent |
| 需要把命令、Skill、Subagent、Hook 作为团队包分发吗? | Plugin |
看完这几种机制,再回头看自己要复用什么。只有一段短流程,就先用单文件 Skill 提供入口,写法见 把常用请求写成 Claude Code 斜杠命令。做过几次审查,发现等级标准、报告模板和资料确实会重复用,再把它们放进包里。
写作、品牌改写、文档、重构和项目规则整理,也可以这样判断。先有稳定方法,再决定需要哪些文件;每份材料都应该服务于具体步骤。
02 Skill 分三层加载
Skill 采用渐进式披露,Claude Code 按任务需要分层加载内容:
| 层次 | 加载内容 | 作用 |
|---|---|---|
| 第一层 | Skill 的名称和描述 | 判断当前任务是否相关 |
| 第二层 | SKILL.md | 读取核心流程、边界和操作说明 |
| 第三层 | references/、templates/、scripts/、assets/ 等支持文件 | 在确实需要时读取或使用 |
Claude Code 的 Skills 文档说明,普通会话里只有各个 Skill 的描述会进入上下文,好让 Claude 知道有哪些可用;完整内容在调用时才加载。名称与描述帮助判断是否适合当前任务;SKILL.md 写核心方法,长资料和可复用产物放支持文件。
回到开头那份 260 行的材料:
| 材料 | 行数 |
|---|---|
| 核心流程 | 40 |
| 安全清单 | 80 |
| 测试清单 | 60 |
| 性能清单 | 50 |
| 报告模板 | 30 |
全放主文件,一次加载 260 行。现在只查鉴权,还需要性能清单吗?不需要的话,读取核心、安全和模板共 150 行,就能留下更集中的材料。
取舍时要看本次判断需要什么。某份清单可以暂时不读,等级标准等必需依据仍要提前拿到。行数只用来说明差别,真正要检查的是“少读这份以后,还能不能作出本次判断”。
03 文件放在哪里、各目录放什么
常见位置有两类:项目级 Skill 放在项目目录 .claude/skills/,供团队共享;个人级 Skill 放在 ~/.claude/skills/,承载个人偏好或跨项目方法。
一个最小 Skill 只需要一个目录和一个 SKILL.md。稍微完整一点的 Skill 通常会这样组织:
my-skill/
├── SKILL.md
├── references/
│   ├── review-checklist.md
│   └── style-guide.md
├── templates/
│   ├── report-template.md
│   └── outline-template.md
├── scripts/
│   ├── collect-context.sh
│   └── validate-output.js
└── assets/
    └── example-output.md
各目录按内容用途分工:
| 目录 | 放什么 | 适合内容 |
|---|---|---|
SKILL.md | 核心说明 | 触发条件、执行流程、边界、输出要求 |
references/ | 参考资料 | 风格指南、规范、规则、检查清单、概念说明 |
templates/ | 输出模板 | 报告模板、提纲模板、文档模板、提交说明模板 |
scripts/ | 辅助脚本 | 收集上下文、运行检查、格式化、生成中间文件 |
assets/ | 示例或素材 | 示例输出、截图说明、固定素材 |
起步时,先把方法写进最小 SKILL.md,用一次真实任务检查够不够。后来发现报告模板重复、清单只在某些条件下需要,再把它们放到相应目录,并在主流程说明何时读取。文件拆开后,要确保材料找得到、用得上。
04 入口字段:name 与 description
SKILL.md 由 frontmatter 和正文组成。Frontmatter 告诉 Claude Code 名称、用途和控制参数,正文说明具体工作流程。一个基础模板如下:
---
name: code-review
description: 用于审查代码变更的专项 Skill。适用于用户要求 review、检查 diff、评估风险、找测试缺口或准备合并请求的场景。
---

# Code Review Skill

## 适用场景

- 用户要求审查当前改动。
- 用户要求检查某个文件或模块的风险。
- 用户要求给出合并前建议。

## 工作流程

1. 先读取当前改动范围。
2. 识别行为变化、兼容性风险、错误处理和测试缺口。
3. 按严重程度排列发现的问题。
4. 给出可执行的修复建议。
5. 输出剩余风险和建议验证方式。

## 输出格式

- Findings:按严重程度列出问题。
- Open questions:列出需要确认的假设。
- Verification:列出建议执行的检查。
为了让名称和触发条件明确,建议显式填写下面两个字段。官方说明所有字段都是可选的,但推荐写 description:
| 字段 | 是否必需 | 作用 |
|---|---|---|
name | 建议填写 | 稳定名称;省略时采用目录名 |
description | 建议填写 | 说明这个 Skill 何时应该触发 |
name 要稳定,description 要写清适用场景和边界。其他字段按用途选:
| 要控制什么 | 字段 |
|---|---|
| 参数提示、工具免确认 | argument-hint、allowed-tools |
| 模型与用户入口 | disable-model-invocation、user-invocable |
| 独立执行 | context、agent |
| 模型或事件处理 | model、hooks |
description 写得太泛会频繁误触发,写得太窄又会漏掉真实需求。怎样用几组请求测出它的宽窄,见 Claude Code Skill 上线前测什么。
05 主文件只写调度,长资料按条件读
Skill 的规则较多时,把长内容拆成支持文件,由 SKILL.md 说明何时读取。例如代码审查 Skill:
code-review/
├── SKILL.md
├── references/
│   ├── risk-levels.md
│   ├── security-checklist.md
│   ├── testing-checklist.md
│   └── performance-checklist.md
└── templates/
    └── review-report.md
SKILL.md 只保留调度说明:
## 工作流程

1. 读取当前变更范围。
2. 如果涉及鉴权、权限、输入校验或外部请求,读取 `references/security-checklist.md`。
3. 如果涉及性能路径、缓存、循环或查询,读取 `references/performance-checklist.md`。
4. 如果需要输出审查报告,使用 `templates/review-report.md`。
拆成文件以后,再沿一次审查走一遍。先判断要查什么,再打开对应安全或性能清单,最后用报告模板,长材料就有了具体的读取时机。
但若每条发现都要分严重程度,风险等级定义要在任何检查前读到,它不是只在安全任务里才需要的细节。把这个前提留在主流程,专题材料再按改动追加。这样省去的是无关读取,判断依据仍然留在原处。
06 一个代码审查 Skill,以及怎样检验它
代码审查 Skill 能固定团队审查标准,因此适合长期共享。SKILL.md 可以这样写:
---
name: code-review
description: 审查代码变更,识别 bug、行为回归、安全问题、测试缺口和可维护性风险。适用于用户要求 review、检查 diff、准备合并或排查近期改动的场景。
allowed-tools: Read Grep Glob Bash(git diff *) Bash(git status *)
---

# Code Review

## 审查重点

- 行为回归
- 边界条件
- 错误处理
- 权限和输入校验
- 数据一致性
- 测试覆盖
- 兼容性和迁移风险

## 执行流程

1. 确认本次变更范围。
2. 阅读相关文件和测试。
3. 优先寻找会导致错误行为的问题。
4. 按严重程度排列发现。
5. 每条发现必须包含文件位置、问题原因、影响和建议修复方式。
6. 如果没有发现明确问题,说明剩余风险和建议测试。

## 输出格式

### Findings

- Severity:
- Location:
- Problem:
- Impact:
- Recommendation:

### Open questions

### Verification
报告有了统一标题,再拿一条发现来检查它。假设 diff 删除了接口权限校验,只写“注意安全”仍无法判断对错。它应指向文件与位置,解释哪个未授权请求会因此通过,再提出能验证这件事的回归测试。
这样才能从输出回到实际行为。工具也单独检查:这里 allowed-tools 只是让读取和 Git 查询免确认,要符合只读角色,还得用 disallowed-tools 或权限规则限制写入。报告是否有依据、执行是否受控,要分别检查。
07 其他几类 Skill 的结构要点
博客草稿 Skill 把写作拆成资料、提纲、草稿、版本和反馈等可控阶段,templates/ 里放提纲模板和草稿模板。先确定目标读者、核心结论、语气和长度,再设计提纲;修改已有文章时,先读取现稿,直接进入迭代,省去重复的资料收集和提纲阶段。
品牌语气 Skill 适用于营销文案、客户沟通和产品公告,可以把规则拆成 voice-principles.md、forbidden-phrases.md、examples.md 三份参考,加一份改写报告模板。这类能力更依赖清楚的规则与正反例,复杂脚本通常不是重点。
重构 Skill 单靠口头吩咐往往不够严谨,最好配几个轻量脚本:一个收集调用链路,一个运行测试,一个对比重构前后的行为差异。流程里要把验证放进主线:重构改善的是结构,现有行为仍须保持正确。
CLAUDE.md 生成 Skill 从项目结构、脚本、配置、测试命令和编码风格中提取协作说明。这份文件会影响以后的会话,所以先分清观察与要求:
| 观察到什么 | 能支持什么判断 |
|---|---|
package.json 包含 Vitest | 当前测试依赖使用 Vitest |
| 最近 30 条提交使用 conventional commits | 历史上常这样提交;还不能认定每次必须如此 |
scripts 有 pnpm db:migrate | 存在迁移命令;是否必须使用,要核对团队约定 |
已确认事实可以保存;强制要求和未验证推测先列出来等确认,免得后续会话把猜测当成规则。
08 放进子代理运行,以及从个人走向团队
大型审查、调研、安全审计和跨模块分析,可能读很多材料。放到子代理里,中间过程留在独立上下文,主会话只收证据和结论。frontmatter 里设 context: fork 就能让 Skill 在子代理里运行,官方提醒它不会继承你和 Claude 之前的对话,Skill 的说明要能独立成立。
交接前想清楚:
需要哪些项目资料和主会话决定?
  → 能否完整交接?
  → 只读还是可修改?
  → 返回完整报告、摘要还是结构化结果?
以安全审计为例,读大量路由时中间材料很多,独立上下文能把这些过程留在外面。换成几行 diff,交接背景、再理解返回结果,也许比直接看更费事。隔离适合长或专门的任务,短小判断留在主会话也完全合理。
Skill 的推广可以沿这条路径递进:
- 先写个人 Skill,验证流程是否好用。
- 再放进项目目录,和团队一起使用。
- 最后把成熟的能力打包成 Plugin。
个人方法交给团队用时,往往还会发现项目约定和依赖上的缺口,先在项目目录把这些问题补齐。等需要一起分发命令、Skills、Subagents、Hooks 和模板时,再放进 Plugin;否则一个方法的试验,就会提前变成整套包的维护。
判断一个 Skill 的文件组织好不好,拿一次真实调用来看就行:这次读进来的每一份材料,是不是都用在了判断上;没读的那几份,是不是本来就用不上。