
DeepDojo.AI发布 2026-11-13更新 2026-11-13English
CLAUDE.md 规则越写越乱,怎么整理
用 Claude Code 久了,CLAUDE.md 里的规则会越积越多:技术栈、测试命令、哪些目录不能动。写下来的那天,它确实替你省了不少口舌。
麻烦往往在一段时间之后出现。去年团队写的是“测试用 npm test”,今年项目早就换成了 pnpm 和 Vitest,却没人去改这份文件。新开一个会话,Claude 照着老规矩执行 npm,报错之后还认真地帮你分析 npm 环境兼容性,把任务带向了无关的方向。
规则之所以要写进文件,是因为对话记不住:换个新窗口,上一轮聊好的约定就归零了;长会话触发上下文压缩后,前面的细节也可能被剪掉。可规则写进文件之后,常见的毛病又有三种:
- 放错层级,个人偏好进了团队文件,或团队规则只存在某个人的机器上;
- 写成项目百科,几百字背景读完,下一步动作没有任何变化;
- 写了却没读到,或者读到了却和另一份规则冲突。
对应的办法是:先问“谁需要这条规则、用在哪些文件上”来选层级,再用“它能否改变下一步行动”来筛内容,最后用 /context 和一个小任务确认它真的被加载、被执行。
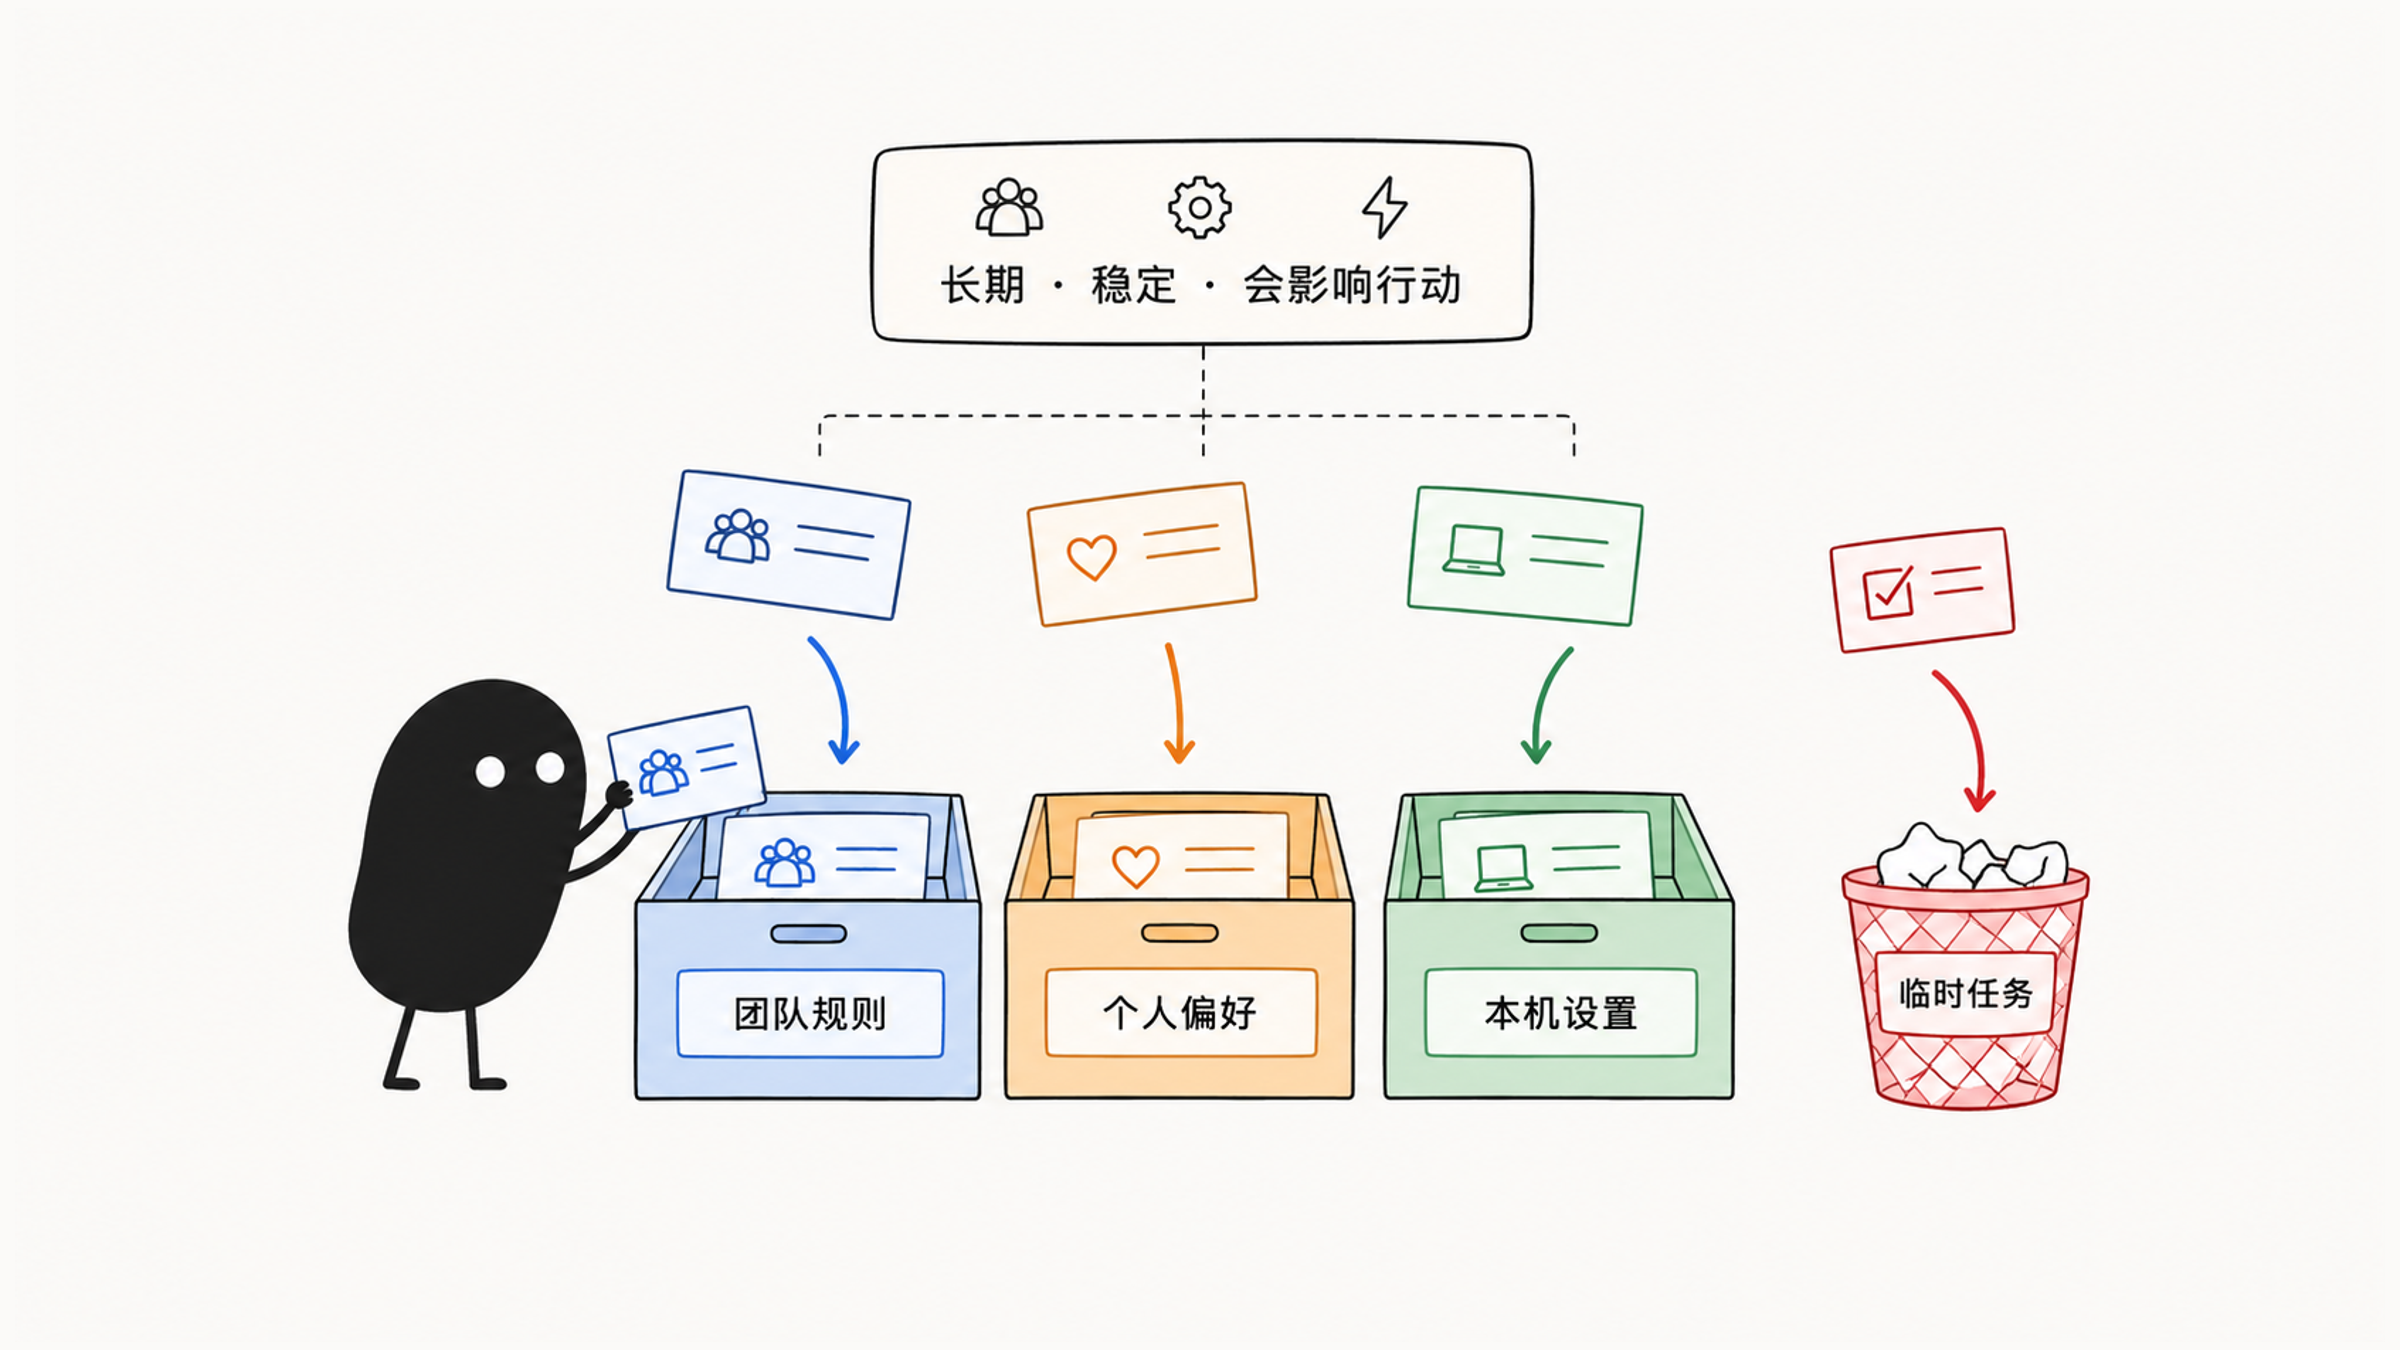
01 先按用途给规则分类
Memory 是专门用来把需要长期遵守的规则保存到文件里的,最典型的载体就是 CLAUDE.md。在提笔写规则之前,先按用途给它们分分类:
| 内容 | 放在哪里 |
|---|---|
| 技术栈、运行命令、架构、目录与修改边界 | 相应项目或目录记忆 |
| 编码、命名、测试、提交、部署和团队安全要求 | 团队共享的规则 |
| 回复长短、先列风险等个人习惯 | 个人记忆 |
| 这次改哪个按钮、尚未确认的实验 | 当前任务 |
| 很少影响行为的长背景、已有大段文档 | 原始项目文档 |
| 密钥、账号、私有 token 和凭证 | 不写入 Memory |
把规则沉淀进文件,固然省去了反复打字的麻烦,但写完就不管,开头那种过期规则就会出现。当它反复做出不符合现状的操作时,先检查它读到了哪些规则,用现在的项目配置核实并清理旧条目,再跑一次同类任务。规则存得久,意味着你多了一项维护责任:只有它始终真实、管用,才值得继续留在那里指导后续的工作。
02 创建、查看和补充记忆
第一次整理项目记忆时,可以在项目根目录运行 /init。Claude Code 会根据当前项目生成或补充项目级 CLAUDE.md。刚生成出来的文件通常包含项目概览、开发规范和常用命令,先把最影响编码的核心规矩留住,剩下的等需要时再慢慢补。
平常维护记忆直接用 /memory 命令,它会打开一个编辑入口,让你挑选不同层级的规则文件。三类事情最适合用它:
- 审查现有记忆有没有过期。
- 把杂乱规则重新组织到合适层级。
- 删除已经不再适用的偏好和约束。
补充规则时,可以直接编辑文件,或明确要求 Claude 写入指定位置:
请把“提交前运行 `npm test`”加入项目根目录的 `CLAUDE.md`;已有同义规则就更新,不重复追加。先确认这确实是项目约定,再写入。只说“记住这件事”可能进入自动记忆;需要团队共享的规则,应明确指定项目文件,并检查实际修改。
03 选层级:谁需要它,用在哪些文件上
Claude Code 的记忆可以来自多个层级,你可以把它理解为一组从组织到个人、从项目到目录的规则:
| 层级 | 常见位置 | 适合内容 | 是否共享 |
|---|---|---|---|
| 受管策略 | 组织配置 | 合规、安全、统一流程 | 组织统一 |
| 项目记忆 | ./CLAUDE.md 或 ./.claude/CLAUDE.md | 团队标准、架构、常用命令 | 通常随项目共享 |
| 项目 rules | .claude/rules/*.md | 模块化项目约定 | 通常随项目共享 |
| 用户记忆 | ~/.claude/CLAUDE.md | 个人偏好、沟通习惯 | 个人 |
| 用户 rules | ~/.claude/rules/*.md | 个人可复用规则 | 个人 |
| 本地记忆 | ./CLAUDE.local.md | 机器相关设置、本地路径 | 本机 |
| Auto Memory | ~/.claude/projects/<project>/memory/ | Claude 保存的反馈、偏好和项目发现 | 本机,按项目保存 |
选位置时,先拿一条具体规则问“谁需要它”。API 统一响应包装器是团队约定,放项目层;回复先结论后细节是个人偏好,放用户层;~/data/dev-seed 是这台机器的路径,就留本地。
再看适用区域。“迁移完成前 src/legacy/ 只读”仍是团队规则,却只涉及一块代码,可以放对应目录的 CLAUDE.md,或用 paths 限定的 rule。谁来用、用在哪些文件上,想清这两点,就能决定放在哪里。
位置近,并不代表一句话能自动压过另一句。按 Claude Code 的 Memory 文档,各层找到的文件会拼接在一起进入上下文,彼此不覆盖;两条指令矛盾时,Claude 可能任选其一。所以冲突要改来源或写清条件,强制阻止访问仍需权限或 Hook。
目录补充可以这样理解:根目录要求所有 API 使用统一响应格式,src/api/CLAUDE.md 再要求输入用 Zod 校验。处理这个模块时,两条要求一起成立。
04 写什么:能否改变下一步行动
项目级 CLAUDE.md 可以写成一份简短的工作约定。历史和背景留在已有文档里,这里主要写会影响下一步行动的要求。一个可用结构可以这样写:
# Project Memory

## Project Overview

This is a Next.js application using TypeScript and PostgreSQL.

## Architecture

- `app/` contains route handlers and UI entry points.
- `server/` contains application services.
- `domain/` contains business types and pure logic.
- Do not import adapters into domain code.

## Development Commands

- Install: `npm install`
- Test: `npm test`
- Lint: `npm run lint`
- Build: `npm run build`

## Coding Rules

- Keep changes scoped to the requested task.
- Use async/await.
- Do not edit generated files.
- Add or update tests for behavior changes.

## Git Workflow

- Review `git diff` before summarizing changes.
- Do not commit unless explicitly asked.
回看模板,每一项都能影响动作:数据库经哪里访问、哪些目录有边界、修改后跑什么、能不能自行提交。先保存这些高频决定,再看项目是否还需要命名、API、迁移、部署、已知问题和关联项目规则。
想往 CLAUDE.md 里再塞一段背景介绍时,先问自己一句:它读完这几百字,接下来的代码动作会有任何不同吗?
写一句“本项目是某某核心业务系统”,对它接下来的编码没有指导意义。写一句“generated/ 目录下所有文件由代码生成器管理,不直接手改”,就明确了不应直接编辑的范围。按“能否改变行动”这把尺子来筛选内容,比把项目 Wiki 逐字搬进来有用得多。
整理时可以对照这张表:
| 常见问题 | 怎么整理 |
|---|---|
| 写成项目百科 | 历史、团队介绍和长背景留在文档 |
| 整份复制已有说明 | 引用来源,或只摘出影响行动的规则 |
| 把“这次先不写测试”存成长约定 | 移回当前任务 |
| 团队规则与个人口吻混写 | 按共享范围分别存放 |
| 只要求“高质量代码” | 明确业务改动补测试、domain 不导入 adapter、提交前跑实际命令等动作 |
| 项目迁移后一直没清理 | 随目录和测试命令更新旧规则 |
05 目录规则与个人规则
大型项目的不同目录往往有不同约束。把所有规则都写进根目录会拉长文件,也会让 Claude Code 在无关任务中读到噪声。目录级 CLAUDE.md 适合写局部规则,例如 API 目录:
# API Module Rules

This file applies to files under `src/api/`.

## Request Validation

- Use Zod schemas for request validation.
- Always validate input before business logic.
- Return 400 for validation failures.
- Include field-level error details.

## Response Format

All responses should follow this shape:

```json
{
  "success": true,
  "data": {},
  "timestamp": "2026-01-01T00:00:00Z",
  "version": "1.0"
}
```
把文件放近代码以后,再确认何时加载。从根目录启动,要等 Claude 读、写或编辑那个子目录里的文件时,才加载那里的记忆;直接从 src/api/ 启动,则会同时取得本目录和所有父目录的规则。文件放在哪里、这次有没有读到,要分别核对。
个人记忆保存你的工作偏好,项目记忆保存团队规则。例如你可以在 ~/.claude/CLAUDE.md 写:
# Personal Preferences

## Response Style

- Keep summaries concise.
- Put risks before nice-to-have suggestions.
- When reviewing code, list findings before general comments.

## Development Preference

- Prefer small, scoped changes.
- Ask before destructive operations.
这些内容只影响你的使用体验。把个人偏好写进项目级 CLAUDE.md,团队其他成员也会用上你的口吻、工具习惯和工作偏好,难以分清哪些是团队要求。想把个人习惯变成团队标准,先确认,再写共享文件。
个人偏好与项目规则应保持一致。例如个人偏好写 npm、项目规定 pnpm,就给个人偏好加上“项目未指定时”的条件,避免两份指令同时要求不同动作。
06 引用、rules 和自动记忆各自怎么加载
CLAUDE.md 可以用 @path 引用外部文件,用一处真实来源替代长文档复制:
# Project Memory

See @docs/setup.md for project setup.
See @docs/architecture.md for architecture rules.
See @docs/testing.md for test commands and policy.
维护单一来源能避免到处复制带来的不同步。但在决定是否加 @ 引用之前,先看清它会在什么场合被用到。
假设你有一份 500 行的架构长文。直接写 See @docs/architecture.md,被引用的文件会展开、和 CLAUDE.md 一起进入上下文,不管问题多小,这 500 行都在里面。如果只写文档的相对路径,并附一句“只有在修改跨层依赖时才读取”,Claude 就只在相关任务里按需查阅。全文导入时,CLAUDE.md 表面上只有一行,消耗的上下文空间一点都没少。
大多数任务都要用 → 用 @路径 导入
只在跨层调整时用 → 写普通路径,说明何时读取
项目规则增多后,把它们拆进 .claude/rules/*.md,每个文件只负责一个主题,例如架构、测试、部署、前端样式或安全边界。单个 rule 文件可以带简短 frontmatter:
---
paths:
  - "src/api/**/*.ts"
---

# API Development Rules

- Validate all request input.
- Keep route handlers thin.
- Put business rules in services or domain logic.
文件名只帮助分主题,真正的加载条件看 paths:
| 写法 | 何时加载 |
|---|---|
| 上例的 API 路径 | 读取匹配的 TypeScript 文件时 |
没有 paths | 启动时 |
只写 description 或换文件名 | 不会因此变成按需加载 |
先想清楚规则必须在什么时候被读到。“不得读取敏感目录”要在访问前可见,并用权限强制限制;等读到目录才加载就晚了。局部开发细节再按路径加载。
还有些内容来自 Claude 自己保存的笔记,也就是 Auto Memory,例如纠正过的偏好或延续使用的决定。它与按目录寻找 CLAUDE.md 是两条来源,目录里的 MEMORY.md 是索引,细节按主题分文件存放。
假设自动记忆留下“不要用 any”,后来团队允许测试文件使用,却只更新了对话和 PR 描述。新会话仍坚持原要求时,就去看它引用的记忆,而不只是重说一次新决定。用 /memory 修改或删除旧记录,后续读到的内容才会跟着变化。
07 排除无关规则与跨目录任务
大型项目可能自动加载与当前工作无关的 CLAUDE.md。这时可以用 claudeMdExcludes 排除,收回上下文空间:
{
  "claudeMdExcludes": [
    "**/packages/legacy-app/CLAUDE.md",
    "**/examples/experimental/CLAUDE.md"
  ]
}
claudeMdExcludes 按绝对路径匹配,所以这里用 **/ 匹配前面的目录。排除后用 /context 检查实际加载结果。适合排除的情况有:
- 旧项目规则已经过期。
- 示例目录规则与主项目冲突。
- monorepo 中某个包的规则不应影响当前包。
- 自动加载的记忆太多,导致上下文噪声明显上升。
如果一个任务需要跨多个目录工作,可以用 --add-dir 把额外目录加入可见范围,比如主项目和共享组件库分开存放时:
claude --add-dir ../shared-components--add-dir 增加文件访问范围,默认不加载额外目录的 CLAUDE.md。确实需要其规则,可在启动时设置 CLAUDE_CODE_ADDITIONAL_DIRECTORIES_CLAUDE_MD=1。额外目录按当前跨目录任务添加,这样既能扩大可见范围,又能保持长期记忆稳定。
08 验证记忆是否生效
写完 Memory 后,先用一个小任务验证 Claude Code 是否真正执行了规则。小任务反馈快,也便于定位问题:
- 重新打开 Claude Code 会话,用
/context检查相关记忆是否已加载。 - 让它解释项目结构,看它是否能说出关键目录职责。
- 让它修改一个小文件,看它是否遵守编码规则。
- 让它准备一次提交说明,看它是否遵守提交规范。
- 在子目录中提问,看目录级规则是否被使用。
没有照做时,按这条路径查:
/context 里没有文件
  → 查位置、启动目录、排除配置
已经加载
  → 查适用范围、具体动作与冲突来源
已经尝试执行,却失败
  → 查命令与运行环境
比如文件已加载,要求却只是“必要时测试”。这时去核对触发条件:团队确认服务端业务改动必须测试,就把条件写出来,再用相关改动看命令和结果。
如果它已经尝试运行,环境却启动不了,下一步查环境并报告阻碍,继续加重语气没有用。沿记录逐项确认:它只是复述了要求,还是加载了文件?已经尝试执行,还是确实完成了?这样才知道该修哪一处。
记忆和命令各管一段:长期规则放记忆,固定流程做成命令,两者的分工可以回看 Claude Code 功能这么多,先学哪几个。团队配置多了以后,同一条规则还容易在记忆、命令和 Hook 里各写一份,团队 Claude Code 配置从一个命令搭起 讲了怎样只留一个来源。
规则写进文件那天起,维护就开始了。项目换了包管理器、改了测试命令,顺手打开 /memory 看一眼,删掉过期的那条,比在对话里一次次纠正省事得多。