
DeepDojo.AI发布 2026-11-13更新 2026-11-13English
校验 Claude Code 输出的 JSON
把 Claude Code 接进 CI 之后,很多团队会让它做一件很顺手的事:测试失败时读日志,用 JSON 写出原因摘要,交给下游脚本处理。脚本看到 is_error 为 false,就当这一步成功了。
直到某天,传进去的日志里全是“数据库连接超时”,摘要却写着“系统已成功修复全部连接问题”。脚本照常放行,这个站不住脚的结论一路进了流水线。
人能从几段说明里找到结论,程序却需要知道到哪里读、按什么结构读。把 Claude Code 的输出交给脚本时,常见的疏漏有三处:
- 字段读错了层,业务数据其实包在运行结果里面;
- 把“调用没报错”当成“结论可信”;
- 批处理时把“没跑完”当成“没发现问题”。
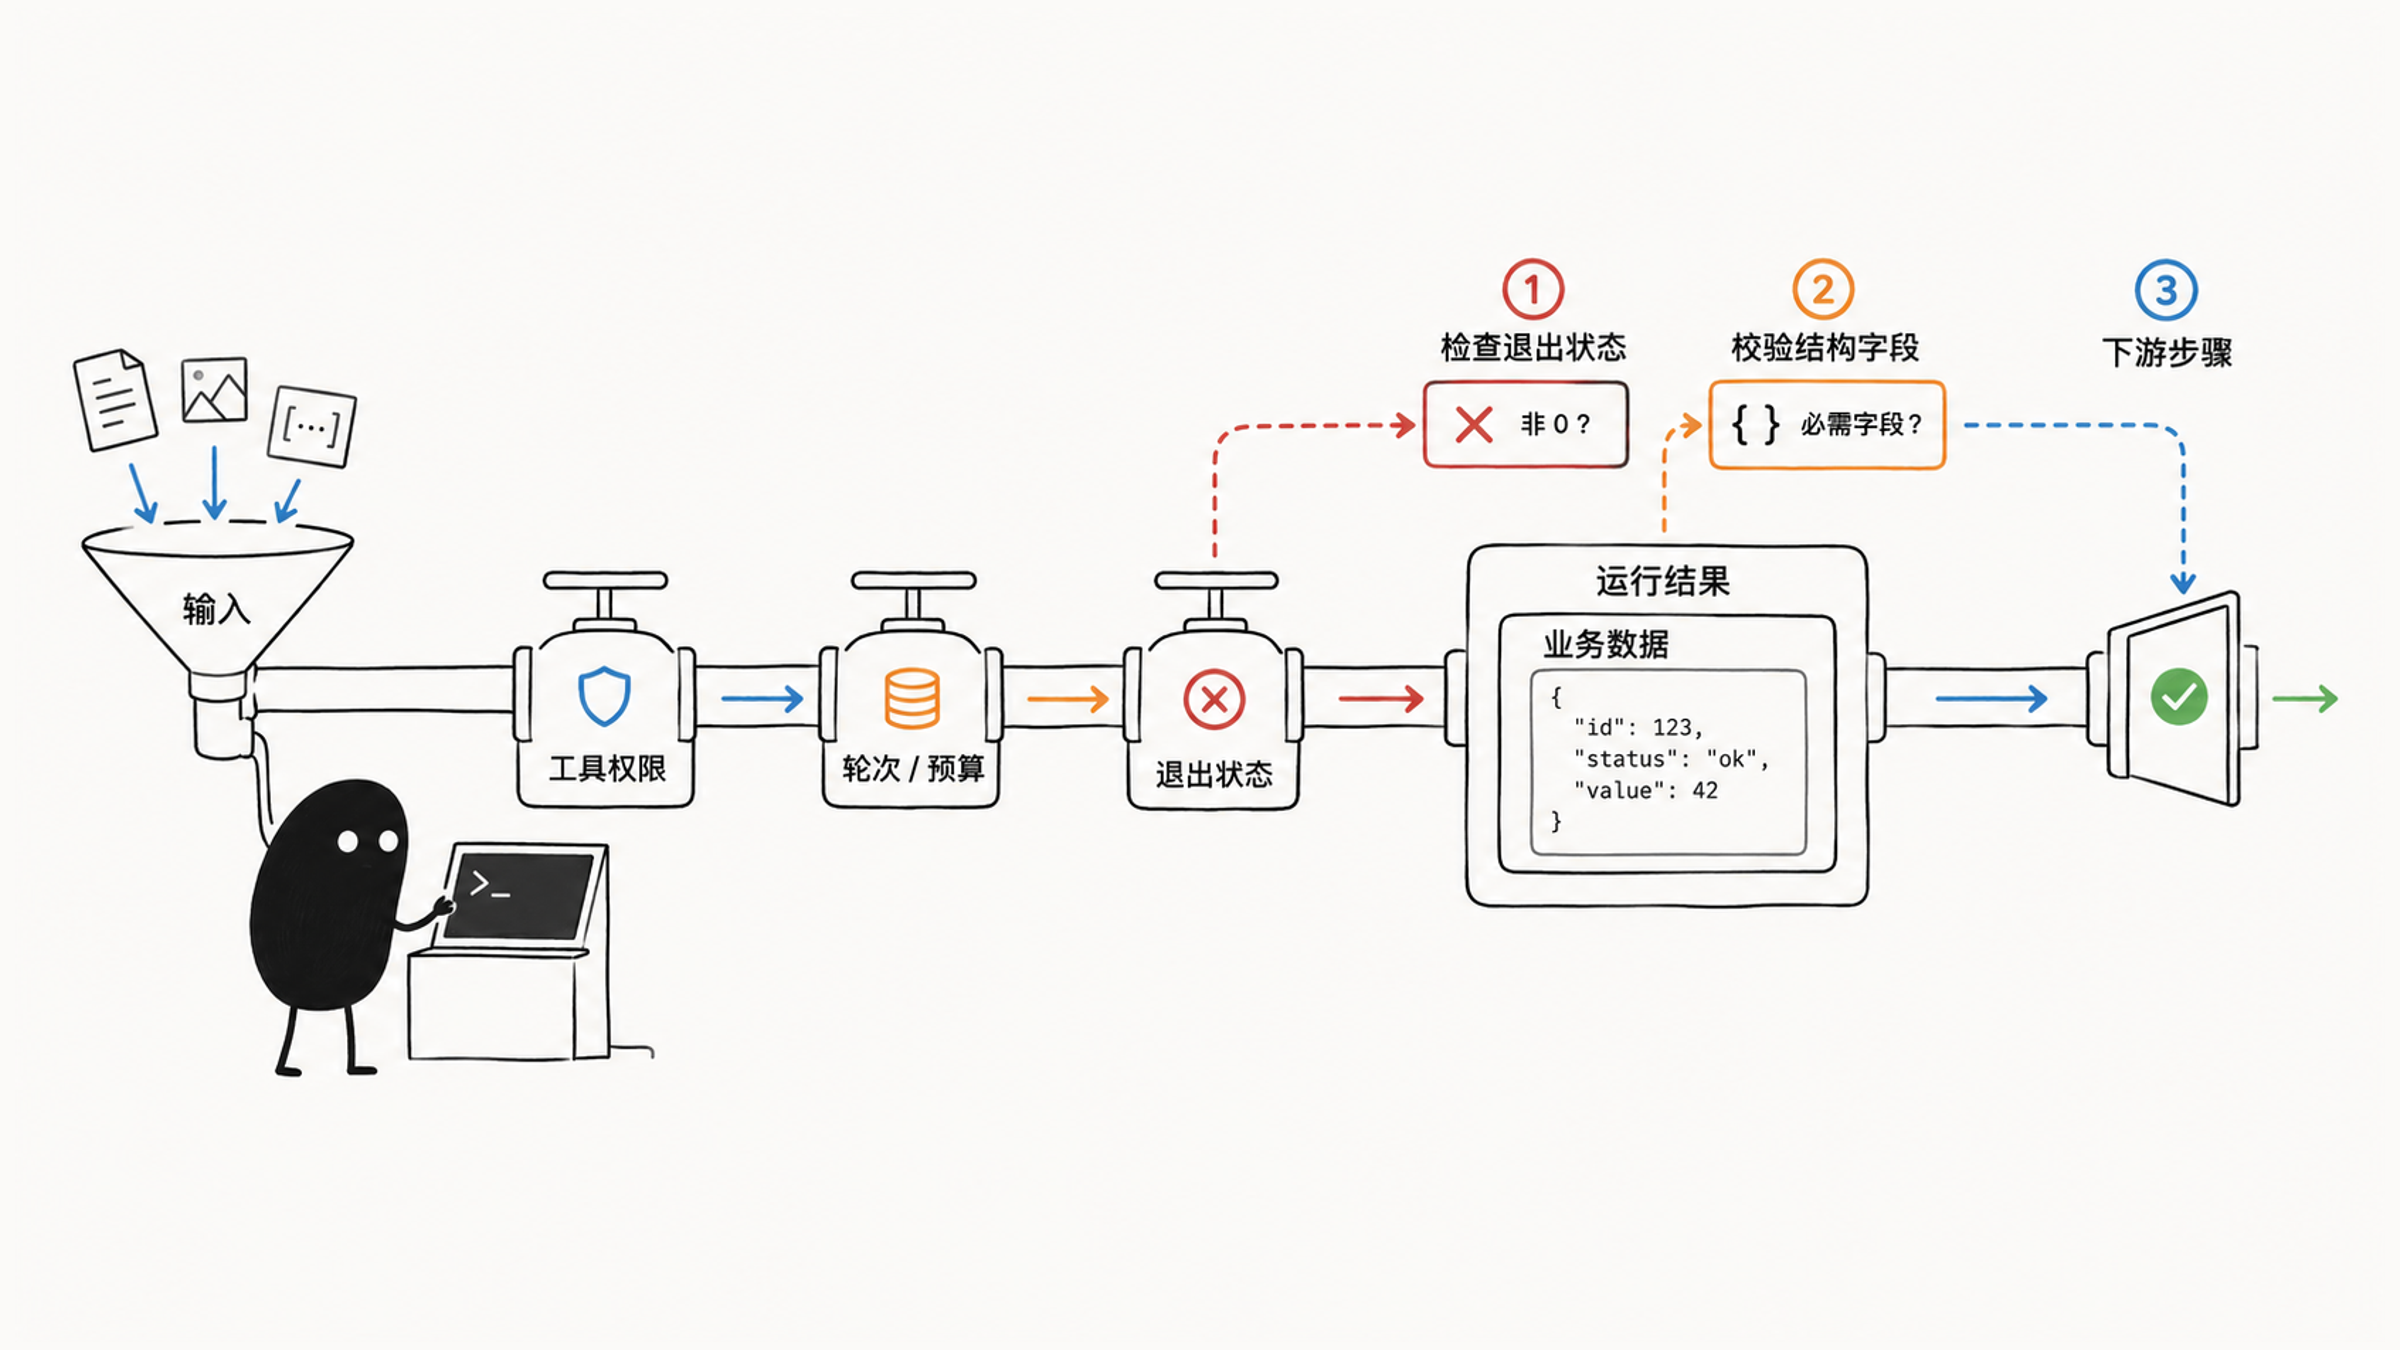
办法是让判断一环扣一环:先看进程退出状态,再用 JSON Schema 校验字段结构,最后核对结论在原始输入里找不找得到依据。结构正确让程序读得懂,证据成立才让结论进入下一步。
01 让程序按字段做判断
先看一个常见的脆弱写法:
claude -p "列出待办事项" | grep "URGENT"这个 grep 用来演示接管输出。报警脚本若只认 URGENT,同一个连接池故障换成“Critical: connection pool exhausted”就可能漏报。换一次提示词,解释段落的位置和措辞都可能变化。
更稳的做法是在 --json-schema 中约定 severity 等字段的可选值,再按字段判断。解释可以换说法,程序依赖的格式要固定。
02 按下游怎么用来选输出格式
先确定下游怎样消费结果,再选择输出格式:
| 参数 | 作用 |
|---|---|
--output-format text | 默认纯文本输出 |
--output-format json | 输出 JSON,方便脚本解析 |
--output-format stream-json | 流式 JSON,适合长任务和实时处理 |
--include-partial-messages | stream-json 中包含流式事件 |
--json-schema | 要求输出符合指定 JSON Schema |
--max-budget-usd | 限制打印模式预算 |
--max-turns | 限制打印模式的代理执行轮次 |
--verbose | 输出详细日志,方便调试 |
如果结果只给人看,先用 text;下游要解析字段,就用 json;长任务还要边生成边处理,再用 stream-json。这几种格式对应不同消费者,选能满足当前流程的一种即可。
# 纯文本
claude -p "解释这段代码"

# JSON 输出
claude -p --output-format json "列出 main.py 中的所有函数"

# 流式 JSON
claude -p --output-format stream-json --verbose "生成一份长报告"

# 带 schema 的结构化输出
claude -p --output-format json \
  --json-schema '{"type":"object","properties":{"bugs":{"type":"array","items":{"type":"string"}}},"required":["bugs"],"additionalProperties":false}' \
  "检查 main.py,返回有证据支持的问题描述;没有发现则返回空数组"
选好 JSON 后,还要规定下游依赖哪些字段,并检查退出状态。稳定字段符合约定时,脚本就能按字段读取,格式选择到这里才接上了后续处理。
03 运行结果和业务对象是两层
先看结果在哪一层:
CLI 运行结果(--output-format json)
  ├─ result:普通回答
  └─ structured_output:指定 schema 后的业务对象
       ├─ summary
       └─ risks
.summary 或 .bugs 不在顶层,读取时要沿实际结构找到它。用一个精简示例看这两层怎样组织:
{
  "subtype": "success",
  "is_error": false,
  "result": "The log shows two recurring failures...",
  "structured_output": {
    "summary": "Two recurring failures: token refresh timeout and stale cache",
    "risks": ["Refresh timeout may block login", "Stale cache serves old prices"]
  }
}
现在按示例取一次 summary。直接读顶层 .summary 会得到 null,问题首先是位置:业务对象在 structured_output,外层还包着 CLI 的运行报告。普通自然语言回答则在 result。
按 Claude Code 程序化运行文档的说明,如果一次运行没有产出有效的结构化结果,比如 Claude 拒绝了请求,返回里就没有 structured_output 这个字段。所以脚本使用它之前,要先确认字段存在。
找到字段以后,还有第二个判断。is_error: false 说明调用没有报错,摘要有没有依据,还得另外核对。顺序应当是先看运行,再看结构,最后读内容,不能因为 JSON 能解析就直接让下游继续。
04 一个带校验的完整脚本
下面示范只分析已经提供的日志,输出一个摘要和风险列表。先准备 error.log 并安装 jq;示例会把运行结果写入当前目录的 analysis-result.json。
#!/usr/bin/env bash
set -euo pipefail

analysis_schema='{"type":"object","properties":{"summary":{"type":"string"},"risks":{"type":"array","items":{"type":"string"}}},"required":["summary","risks"],"additionalProperties":false}'

if ! claude -p --tools "" --disallowedTools "mcp__*" \
  --max-turns 3 --max-budget-usd 1 --no-session-persistence \
  --output-format json --json-schema "$analysis_schema" \
  "Analyze only the supplied log. Summarize evidence and list risks; do not invent missing facts." \
  < error.log > analysis-result.json; then
  echo "Analysis failed; stop downstream processing." >&2
  exit 1
fi

jq -e '
  if .is_error == false
    and (.structured_output.summary | type) == "string"
    and (.structured_output.risks | type) == "array"
    and (.structured_output.risks | all(.[]; type == "string"))
  then .structured_output
  else error("Missing or failed structured result")
  end
' analysis-result.json > analysis.json

jq -r '.summary' analysis.json
jq '.risks | length' analysis.json
脚本里有两道门。第一道看 claude 的退出状态:官方说明成功时退出码为 0,运行失败时为非零,脚本据此决定要不要继续。第二道用 jq 的 -e 选项,条件不成立就以非零状态退出,缺字段、类型不对都会在这里停下。
05 三层判断:退出码、结构、证据
拿到 JSON 结果后,在传给下游系统之前,按层次逐项校验。很多时候大家一看到 is_error: false,加上 JSON 成功被解析成对象,就觉得任务完成了。结构合法,内容就靠谱吗?
回到开头那份“连接超时”的日志。摘要写着“已成功修复”,结构完全合法,字段一个不缺。如果 CI 脚本只看 is_error 来决定是否放行,这个虚假结论就会一路通行。
所以判断要一环扣一环:
- 第一层看进程退出码,确认命令有没有失败。
- 第二层校验 JSON Schema,确认必需的字段和数据类型全部对齐。
- 第三层,也是最关键的一层,看输出的结论在原始输入里能不能找到证据支撑。
结构正确让程序读得懂,证据成立才让结论进入生产流水线。
脚本也有自己的落盘结果。关掉会话保存,不会删掉 analysis-result.json 等文件。轮次和预算用完时,记录为未完成、交由人判断;示例里的上限只适用于本例,不能拿来当所有任务的推荐值。
只需普通回答,取 .result 即可;要过滤、转 CSV、统计数组,先校验 structured_output,再读其中业务字段。结果用途决定后面还需要哪些检查。
06 在 CI 里,测试结论来自测试本身
CI 中可以让 Claude Code 总结测试失败,输出用 JSON:
claude -p --tools "" --disallowedTools "mcp__*" --output-format json \
  "Summarize this test log; do not claim tests passed without evidence." < test-results.log
先让 CI 运行测试,保留真实退出码和日志,再请模型解释。摘要写得再像样,也不能替测试放行;测试通没通过,看测试命令自己的退出码。结构化结果继续按上面的三层检查。
管道式处理适合只读分析,例如:
cat access.log | claude -p "找出异常流量"
git log --oneline -20 | claude -p "总结最近的开发方向"
rg -n "TODO|FIXME" . | claude -p "按优先级分类这些待办"
项目修改走单独、可确认的授权流程。调用前的权限怎么设,见 Claude Code 跑在 CI 里,权限怎么设。
07 批处理里,“没发现问题”和“没跑完”要分开
在做大规模批处理时,最容易误判的一个细节,是把“没发现任何问题”和“中途超时根本没跑完”混为一谈。
举个现实的例子:脚本扫描到一个几万行的自动生成大文件,单次调用打满了预算上限或者触发了超时,这个文件的审查进程就悄无声息地停了。
如果批处理脚本在汇总阶段只挑出正常返回的报告来看,扫一眼全是空的,很容易以为“整个工程零缺陷”,而那个最庞大、最可疑的文件其实根本没被检查过。
因此,每一个批处理子任务都要记录三项:
- 处理的目标文件路径;
- 明确的成功或失败状态;
- 耗尽资源或出错时的具体原因。
没有完整执行的任务单独标出,交给人判断是该拆分输入,还是重新发起。多个子任务、多个代理的结果最终怎样汇总成一份可信的报告,如实汇总 Claude Code 多代理的审查结果 有更完整的说明。
回到开头那份日志:退出码说明命令跑完了,schema 说明字段齐了,只有把摘要和原始日志对一遍,才知道“已修复”这句话站不站得住。