
DeepDojo.AI发布 2026-11-13更新 2026-11-13English
Claude Code Hook 为什么没拦住?
给 Claude Code 配好拦截危险命令的 Hook 之后,大多数人会测一下:故意让它执行一条该拦的命令,看到终端里冒出一个非零退出码,就放心了。
这个结论下得太早。比如换到一台没装 jq 的新机器,检查脚本一启动就报 jq: command not found,以退出码 127 结束。安全检查根本没跑,而按 Claude Code 的规则,这种“脚本自己出错”只算非阻断错误,原本要拦的调用照常执行。
门禁看起来在、实际没拦住,通常出在三个地方:
- 退出码用错了,脚本崩溃被当成了正常放行;
- 规则靠字符串黑名单,换一种写法就绕过去了;
- 完成度检查陷入循环,或者在不适用的任务上反复阻断。
对应的办法是:把“门禁主动拒绝”和“脚本自身报错”在逻辑上拆开;把真正的安全边界交给工具白名单、沙箱和低权限账号;给 Stop 检查加上适用判断和降级退出。验证时分两步走,先拿合成 JSON 测脚本本身,再挂到真实事件上测配置。
01 退出码决定是放行、阻断还是出错
Hook 的退出码会影响 Claude Code 后续行为:
| 退出码 | 含义 |
|---|---|
0 | 脚本正常结束;结构化输出仍可要求拒绝或继续处理 |
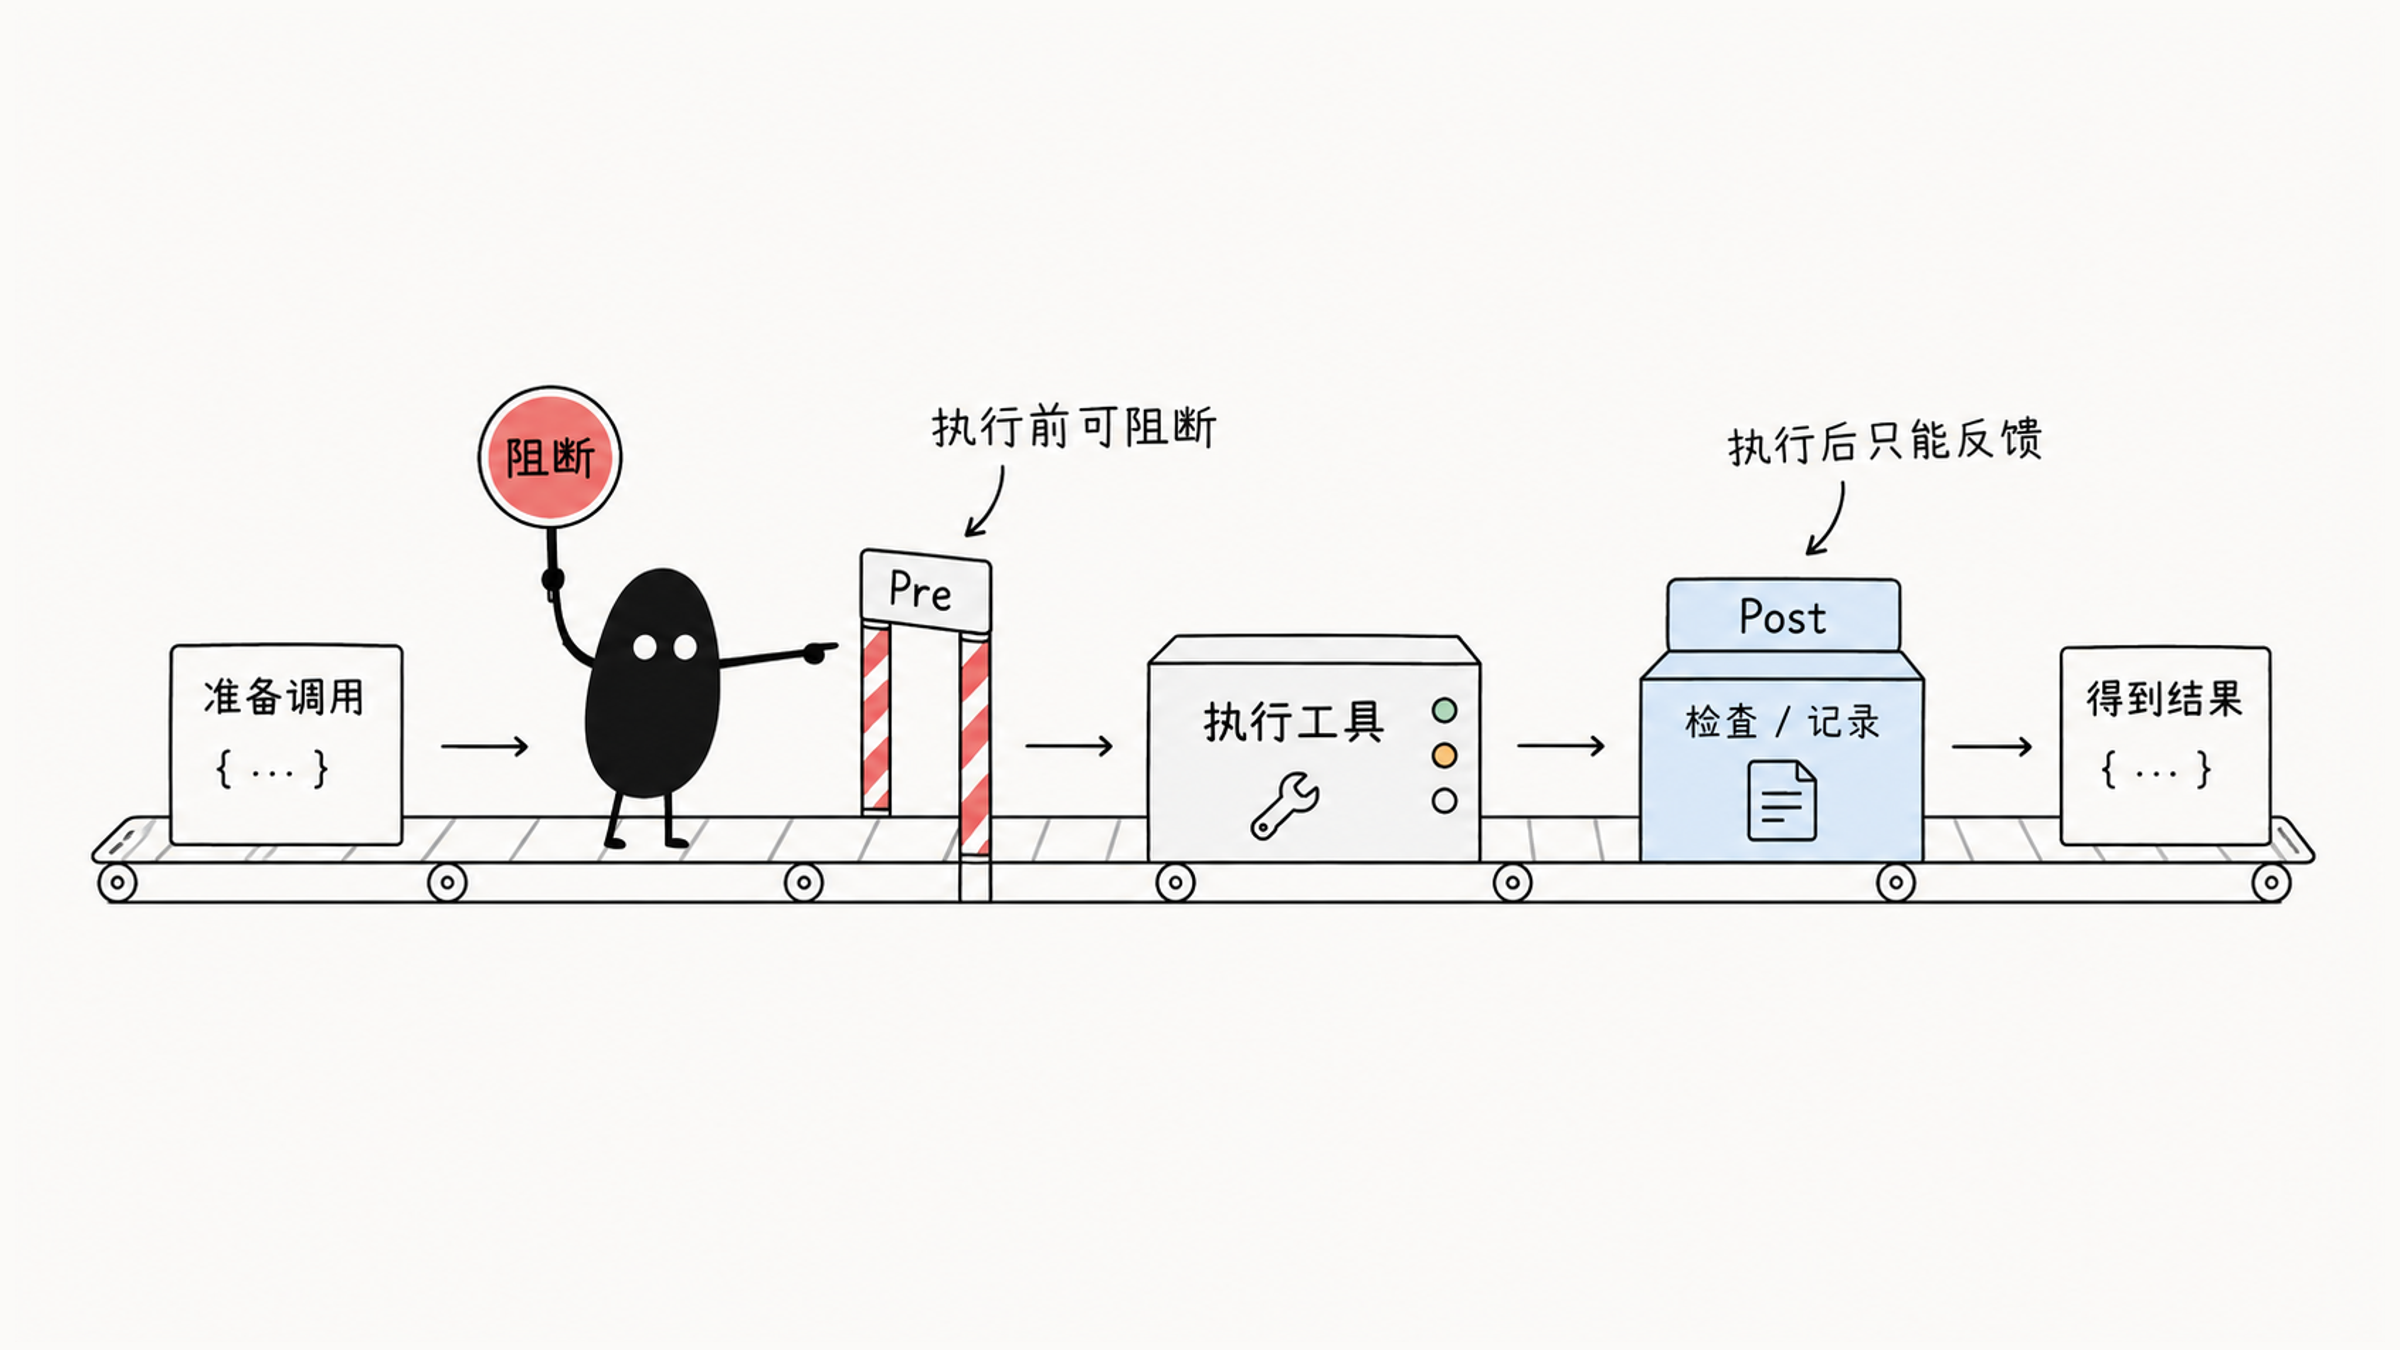
2 | 按事件执行阻断或反馈;例如 PreToolUse 可阻止调用,PostToolUse 不能撤销已完成动作 |
| 其他非零值 | 非阻断错误,动作照常进行,不能当作安全门禁已拒绝 |
Claude Code 的 Hooks 参考对第三类写得很明确:脚本以其他退出码结束,或者根本没能启动、输出了无法解析的 JSON,都算非阻断错误,动作照常进行,界面上只会出现一条“hook error”提示。PreToolUse 上的 Hook 超时也不会拦住调用。
所以,一个路径写错或者依赖缺失的策略 Hook,会把所有调用都放过去。官方提供了一个开关:在 command 或 http 类型的 Hook 上设置 "onFailure": "block"(需要 Claude Code v2.1.295 或以上),Hook 失败或超时时就阻止这次动作。用作安全门禁的 Hook,值得考虑这个设置。
测试 Hook 脚本时,依次覆盖以下四种情况:
- 正常放行(返回 0)。
- 主动安全阻断(按规范返回 2)。
- 依赖缺失或语法报错(脚本自身崩溃)。
- 接收到格式错乱的畸形输入。
要把“门禁主动识别并做出了拒绝决定”和“检查脚本自身报错”这两件事从逻辑上拆开。
02 先测脚本,再测挂载
在把 Hook 挂到真实事件之前,最扎实的验证办法是先拿几份伪造的测试 JSON 送进脚本的 stdin,亲眼看着它在命中拦截规则时打出阻断信号。
确认脚本本身逻辑无误之后,再去 Claude Code 里配上真正的事件,拿无害的测试命令验证它在整个运行链条里有没有把工具调用卡住。把“脚本逻辑正确”和“系统挂载生效”分两步走,出事时才不会对着一堆配置无从下手。
返回什么,也从用途往回想。只想留下审计记录,就写日志;希望 Claude Code 根据扫描结果继续处理,就按当前事件协议返回 JSON。脚本打印出一段说明,不代表模型一定按你期望的方式接收到它。常见输出字段包括:
| 字段 | 作用 |
|---|---|
continue | 是否继续 |
stopReason | 停止原因 |
suppressOutput | 是否抑制输出 |
systemMessage | 系统提示消息 |
hookSpecificOutput | 事件特定输出 |
在 PreToolUse 中,hookSpecificOutput 可以包含 permissionDecision、permissionDecisionReason 和 updatedInput。在 PostToolUse 中,可以包含 additionalContext 和 updatedToolOutput:前者把扫描结果交给 Claude 继续处理,后者替换工具输出,值要符合该工具的输出格式。
03 危险命令黑名单只演示机制
危险命令要在执行前拦截,因此选择 PreToolUse 并匹配 Bash。脚本示例:
#!/usr/bin/env bash
set -euo pipefail

INPUT="$(cat)"
if ! COMMAND="$(printf '%s' "$INPUT" | jq -er '.tool_input.command | select(type == "string")')"; then
  echo "Cannot inspect command input; refusing this call." >&2
  exit 2
fi
LOG_DIR="${CLAUDE_PROJECT_DIR:-$PWD}/.claude/hooks"
if ! mkdir -p "$LOG_DIR"; then
  echo "Cannot create audit directory; refusing this call." >&2
  exit 2
fi
LOG_FILE="$LOG_DIR/audit.log"

log_decision() {
  printf '%s\t%s\n' "$(date -u +%Y-%m-%dT%H:%M:%SZ)" "$1" >> "$LOG_FILE"
}

DANGEROUS_PATTERNS=(
  "rm -rf /"
  "sudo rm"
  "mkfs."
  "format c:"
  ":(){ :|:& };:"
)

for pattern in "${DANGEROUS_PATTERNS[@]}"; do
  if printf '%s' "$COMMAND" | grep -Fiq -- "$pattern"; then
    log_decision "BLOCK:$pattern" || true
    echo "Blocked command matching a dangerous literal pattern." >&2
    exit 2
  fi
done

if ! log_decision "NO_MATCH"; then
  echo "Cannot record the check; refusing this call." >&2
  exit 2
fi
exit 0
这段脚本有个细节值得留意:输入解析不了、日志写不进去时,它都选择以退出码 2 拒绝,而不是让错误变成放行。
拿合成输入跑通之后,你可以看到这几条危险命令是怎么被抓到、又是怎么被退出码 2 阻断的。可多换几种写法,就会发现它的局限:rm -rf $TARGET_DIR、参数顺序打乱的 rm -f -r /,或者通过 eval、xargs 或别的解释器包装一层,这些匹配规则都会被绕过。
所以这个示例的作用,是展示“事件触发与退出码阻断”这套机制怎么配合。生产环境里的安全边界,要靠受限的工具白名单、系统级沙箱隔离,以及低权限运行账号层层设防,几行字符串黑名单守不住。
审计日志也是同理,记录做出阻断决定的关键元数据即可。把捕获到的整条命令不脱敏就写进文本文件,很可能在日志里留下一份明文的数据库连接串或 API 密钥。用 PostToolUse 记录实际执行过的 Bash 命令时同样如此,团队启用前要明确脱敏、访问权限和保留周期。
04 敏感信息扫描:文件已经写下了
安全扫描放在 PostToolUse,因为它检查的是刚写入或编辑后的文件。扫描目标可以包括 password = "..."、"api_key": "..."、secret = "..."、私钥片段、token 和连接串。发现疑似问题时,用 additionalContext 反馈给 Claude Code:
#!/usr/bin/env python3
import json
from pathlib import Path
import re
import sys

try:
    data = json.load(sys.stdin)
    file_path = data.get("tool_input", {}).get("file_path")
    if not file_path or not Path(file_path).is_file():
        sys.exit(0)
    content = Path(file_path).read_text(encoding="utf-8")
except (ValueError, OSError, UnicodeError) as error:
    print(f"Security scan could not complete: {type(error).__name__}", file=sys.stderr)
    sys.exit(1)

pattern = re.compile(r"(?:password|api[_-]?key|secret|token)[\"']?\s*[:=]\s*[\"']", re.I)
lines = [str(number) for number, line in enumerate(content.splitlines(), 1)
         if pattern.search(line)]
if lines:
    message = ("Possible hardcoded credential assignment at lines " + ", ".join(lines[:20])
               + ". Inspect locally; do not repeat credential values in the response.")
    print(json.dumps({"hookSpecificOutput": {
        "hookEventName": "PostToolUse", "additionalContext": message
    }}))
收到行号后,先回到文件看那一行:是实际凭据,还是示例里的占位符?正则只找到相似写法,还没有作出这个判断。它也刻意不返回值本身,后续说明继续沿用行号即可。假设第 14 行被标记,后续处理这样走:
PostToolUse 返回 additionalContext
  → Claude 检查第 14 行
  → 需要时改用环境变量引用
  → 核对实际文件,说明暴露凭据的轮换需求
如果只写日志,当前轮可能继续推进,直到人工复查才发现问题。追加上下文,能把行号及时交回 Claude 处理。不过时间顺序没有改变:文件已经写入,修正后还要核对实际结果。提交和发布前继续做独立扫描;若确认凭据已经泄露,还得撤销或轮换,改掉文件内容并不能恢复凭据安全。
05 请求文字检查只是一层线索
UserPromptSubmit 在 Claude 处理用户输入前触发,适合做请求层面的检查,比如拦截“删除数据库”“格式化磁盘”“禁用安全机制”这类明显危险的请求。脚本可以这样写:
#!/usr/bin/env bash
set -euo pipefail

INPUT="$(cat)"
PROMPT="$(printf '%s' "$INPUT" | jq -r '.prompt // ""')"

BLOCK_PATTERNS=(
  "delete.*database"
  "drop.*production"
  "rm -rf /"
  "format disk"
)

for pattern in "${BLOCK_PATTERNS[@]}"; do
  if printf '%s' "$PROMPT" | grep -Eiq -- "$pattern"; then
    echo "This request looks dangerous. Please clarify the target environment and safety plan." >&2
    exit 2
  fi
done

exit 0
把同一句话换个表达,正则可能认不出;问“解释如何避免删除数据库”,又可能因关键词相同被拦住。这说明请求文字只能提供一层线索。启用前,既测该拦的请求,也测正常讨论;真正要执行工具时,还要检查实际参数,文字校验当不了最终边界。
06 Stop 检查要先判断适不适用
Stop 在主回复结束时触发,适合检查输出是否满足要求,比如是否运行了必要测试、是否给出了验证结果、是否遗漏用户要求。这类检查可以用 Prompt Hook 或 Agent Hook。
拿“每次回复结束前必须包含完整的测试运行结果”这条规则来推演一下。改动后端支付逻辑时,它确实能守住质量底线。可如果这一轮用户只是让你修正 README 里的一个错别字,改文档根本不需要跑测试:Claude 尝试结束,Hook 阻断;Claude 重试,还是没有测试结果,Hook 再次阻断。任务就这样在循环里打转。
官方给这种循环设了上限:Stop Hook 连续让同一轮继续 8 次后,Claude Code 会忽略下一次阻断,直接结束这一轮;Claude 中途调用过工具,计数就重新开始。上限可以用 CLAUDE_CODE_STOP_HOOK_BLOCK_CAP 调高。这个上限只能终止循环,检查逻辑本身还要合理。
所以给任务做完成度门禁,先动态判断“本次任务适不适用这项验收标准”。即便确实改了业务代码需要跑测试,碰上本地数据库刚好挂了、网络不通等环境限制,Hook 仍然要求“测试必须全部通过”,会话就会卡在“运行测试、失败、阻断、重试”的循环里。
这时用好 stop_hook_active:Claude 已经因为上一次 Stop Hook 而继续时,这个字段为 true。发现这是拦截后的重试,就允许模型如实说明“我已经尝试跑测试,但本地端口被占用无法启动”,以一种未全部通过、但事实清楚的状态正常结束。
输出方面,Stop 支持用退出码 0 配合 decision: "block" 和具体的 reason 阻止结束,也可以用 additionalContext 追加指引让这一轮继续。按 Stop 的事件协议选择输出,并先检查循环状态,各事件的反馈字段按各自协议使用。
07 排查顺序:配置、匹配、脚本、输出
Hook 出问题时,按配置加载、事件匹配、参数过滤、脚本执行、输出解析的顺序检查:
- 脚本路径是否正确,是否有执行权限。
settings.json是否是合法 JSON。- 事件名是否写对,
matcher是否匹配到正确工具。 if是否放在正确层级。- 脚本是否能从 stdin 读取 JSON,是否把用户可见错误写到 stderr。
- 退出码是否符合预期。
- 本地依赖工具是否存在,比如
jq、prettier、black、gofmt。
可以先写一个最小调试 Hook:
#!/usr/bin/env bash
set -euo pipefail

mkdir -p "$HOME/.claude"
jq -c '{hook_event_name, tool_name, session_id}' >> "$HOME/.claude/hook-debug.log"
printf '\n---\n' >> "$HOME/.claude/hook-debug.log"
exit 0
调试从脚本本身开始:把合成 JSON 送入 stdin,核对退出码和 JSON 输出,依次覆盖正常调用、命中规则、坏输入与依赖缺失。测试时把危险命令作为输入字符串,不真正执行。
这些结果符合预期后,再把脚本挂到目标事件,用无害调用确认触发。如果合成输入能阻断,实际调用却没有反应,先保留脚本里的识别规则,沿事件名、匹配条件和配置来源往前查。用一个无害的专用条件确认绑定,再回来测试业务规则。否则你可能不断改危险命令模式,真正没加载的却是配置。
事件和匹配条件怎么选,见 Claude Code Hook 该挂在哪个事件上。一个团队的多个 Hook、命令和规则同时调用格式化或检查工具时,怎样避免各写一份,见 团队 Claude Code 配置从一个命令搭起。
门禁类 Hook 上线前,值得专门做一次破坏测试:故意删掉依赖、写错路径、喂一段坏 JSON,看它是拦下调用,还是悄悄放行。