
DeepDojo.AI发布 2026-11-06更新 2026-11-10English
复杂任务交给 AI Agent,先拆步骤再设检查点
你让 Agent“帮我分析 200 条客户反馈,找出最重要的问题,并给出改进建议”,它可能给你这样一段话(模拟):
用户主要不满价格、配送和客服,建议优化价格策略、提升物流效率、加强客服培训。这段话读起来很顺,但没有分类结果、频次和用户原话,读者无法核对结论。如果只让 Agent 根据一句话生成最终结果,实际任务中的步骤依赖和检查点就容易被忽略。
准备客户会议、整理项目复盘、处理客户反馈、生成课程大纲,这些任务通常都需要分步骤推进,例如:
收集信息 -> 筛选重点 -> 生成结果 -> 检查风险 -> 交人确认问题出在一句话任务省略了太多:客户是谁,之前沟通过什么,哪些结论要有依据,哪些步骤依赖前一步的结果。
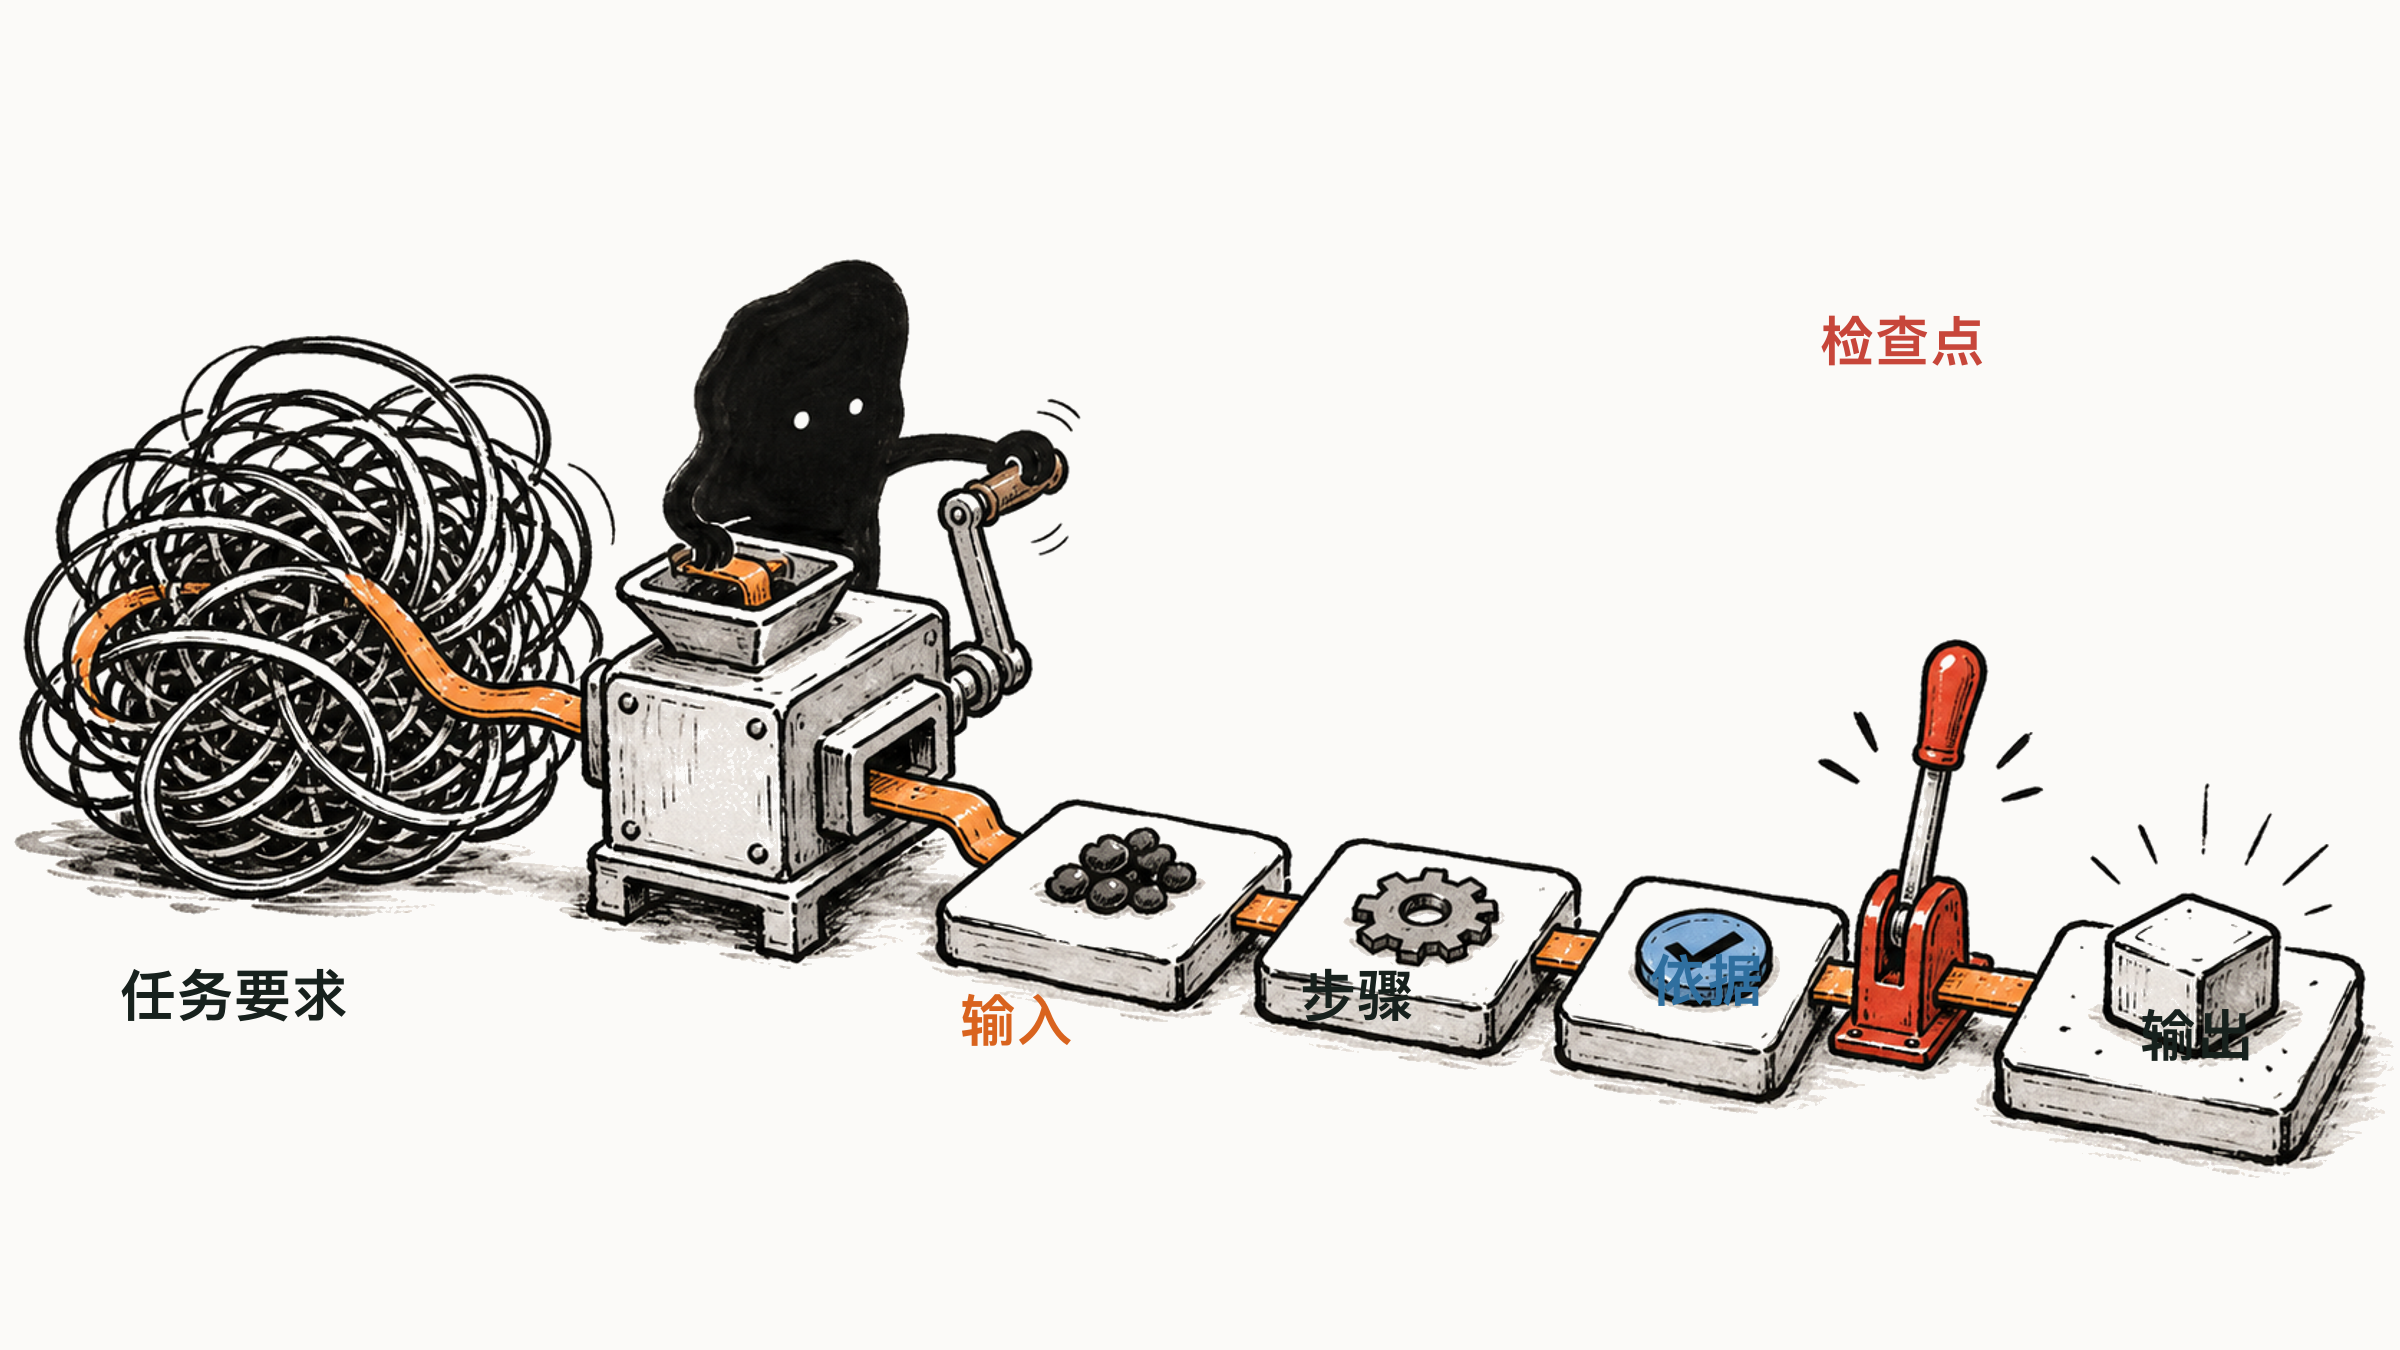
好的做法是把任务拆成具体的步骤,每一步写清输入和输出,让后一步接得住前一步;再看哪些问题最该优先处理,既看出现的频次,也看影响有多严重。
步骤之间还要设检查点,把错误拦在成本高的环节之前,免得分类一开始就错了,要等整份报告写完才回头重做。
01 一句话任务省略了什么
先看一个常见请求:“帮我准备明天的客户会议。”这句话给出了目标,却省略了完成目标所需的步骤:客户是谁?之前沟通过什么?会议目标是什么?客户最关心什么?哪些承诺不能随便说?会后要输出什么?
如果 Agent 拿到这句话就直接给你一份会议议程,客户资料、历史沟通、风险边界和确认点很可能还没有核对过。先把任务拆成有依赖关系的步骤:
1. 确认会议目标
2. 查看客户背景和历史沟通
3. 提取客户关心的问题
4. 准备会议议程
5. 生成可能问题和回答要点
6. 标出不能承诺或需要确认的内容
7. 输出会议准备清单
这个顺序先建立事实和目标,再生成议程与回答要点,最后检查承诺边界,便于逐项核对会议准备是否完整。
02 好流程每一步都能检查
设计流程时,要让每一步都能检查。把任务拆成具体动作,才容易发现猜测和遗漏。对比两种写法:
| 写法 | 问题 |
|---|---|
| 帮我分析客户反馈并给建议 | 太大,Agent 可能直接输出泛泛建议 |
| 先分类反馈,再统计高频问题,再标出证据,再给建议 | 每一步有清楚依据 |
回到那 200 条反馈,按证据生成顺序,可以拆成:
步骤 1:读取反馈,排除无关内容和同一条反馈的重复导入,保留原始编号。
步骤 2:按问题类型分类,例如价格、配送、功能、客服、使用体验。
步骤 3:按统一口径统计每类问题涉及的反馈条数。
步骤 4:为每个高频问题摘出代表性原话。
步骤 5:区分确定结论和资料不足。
步骤 6:根据证据提出改进建议。
步骤 7:输出问题表、证据和建议。
“去重”只处理同一条记录被重复导入的情况。不同客户都说“配送慢”,是多条反馈,文字一样也不删。统计前还要约定口径:一条反馈同时提到配送和客服,就配送 +1、客服 +1,各类条数加起来可能超过 200 条总数。先统一统计口径,数字才有可比性。
03 优先级看两个维度
分类、条数和代表性原话,都能对照原始反馈核对。排优先级时,看两个维度:
出现次数:120 条说配送慢   -> 高频,要分析
后果严重度:2 条说看到别人的订单 -> 少见,但要马上核实是否越权读取
“最重要”由这两个维度一起决定,只按条数排会漏掉严重问题。那 2 条在核实之前,记为“严重风险线索”,核实之后再判断是否发生了数据泄露。这套流程先建证据、再给建议,跳步和遗漏都容易看出来。
04 步骤之间靠输入输出衔接
为每个步骤写清输入和输出,后一步才能接住前一步结果:
| 步骤 | 输入 | 输出 |
|---|---|---|
| 分类反馈 | 客户原始反馈 | 问题分类表 |
| 统计频次 | 问题分类表 | 高频问题列表 |
| 提取证据 | 高频问题列表和原文 | 每个问题的代表性原话 |
| 生成建议 | 高频问题、严重后果问题及对应证据 | 改进建议和优先级 |
| 检查风险 | 建议和资料缺口 | 需要人工确认的问题 |
输入写清楚,可以减少 Agent 自行猜测;输出写清楚,后续步骤就更容易使用。表格已经生成,任务却在这里中断了,下次从哪里继续?这就要靠任务状态:每完成一步,把已完成内容、关键决定和下一步记下来,恢复时 Agent 才能找到断点和后续依据。
这种跨步骤记录进度的做法,可以对照 Anthropic 介绍的结构化笔记:把关键状态保存在上下文之外,需要继续时再读回来。
05 检查点放在哪
一个分类错误,会怎样传到后面?客户反馈分类一开始就把“配送延迟”误分成“客服态度”,后面的统计和建议全会跟着错。等报告写完再改,就要回头重做多步。所以要设检查点,在高成本步骤之前把错误截住。检查点可以很简单:
分类完成后,先展示分类规则和样例。
资料不足时,停止生成确定结论。
涉及承诺、价格、合同、退款时,等待人工确认。
最终输出前,检查是否每条建议都有依据。
检查点通常放在三类位置:
| 位置 | 例子 | 防止什么 |
|---|---|---|
| 工具调用前 | 发邮件、提交退款、删除文件前确认 | 防止误操作 |
| 资料不足时 | 没找到条款、负责人不明确 | 防止编造 |
| 阶段输出后 | 分类完成后先展示样例 | 防止后续步骤建立在错误基础上 |
检查点还要写清怎么算通过。反馈写着“配送晚了”,分类表却标成“客服态度”,就先修正分类、重算受影响的类别,再检查按旧数字给过的建议。还要分清“执行过”和“通过”:表格生成了,只说明这一步跑过;分类对得上原文,才算通过、才能进统计。
如果一个 Agent 忙不过来,需要拆给多个 Agent,就看什么时候该用多个 Agent。流程可以很短,但关键检查点要保留,这样才能及时发现问题。
Anthropic 的提示词链式工作流也在中间步骤加入程序检查,让后续处理建立在已通过检查的结果上。