
DeepDojo.AI发布 2026-11-06更新 2026-11-09English
AI Agent 可靠性测试:固定样例与过程记录
你做了一个合同审查 Agent,给它一份合同,它成功找出付款条款和违约风险。能不能说它靠谱了?
只能说它通过了当前这道题。换一份资料、换一个用户、换一种问法,结果可能完全不同。判断可靠性,要结合有代表性的测试和过程记录。
你要看三件事:固定任务上的表现是否稳定、执行过程是否可追踪、错误能否定位并改进。
一次通过,说明的只是这一道题,要看它在一组有代表性的任务上是否稳定:不同长度的合同、缺失的信息、互相冲突的条款,都得放进去。
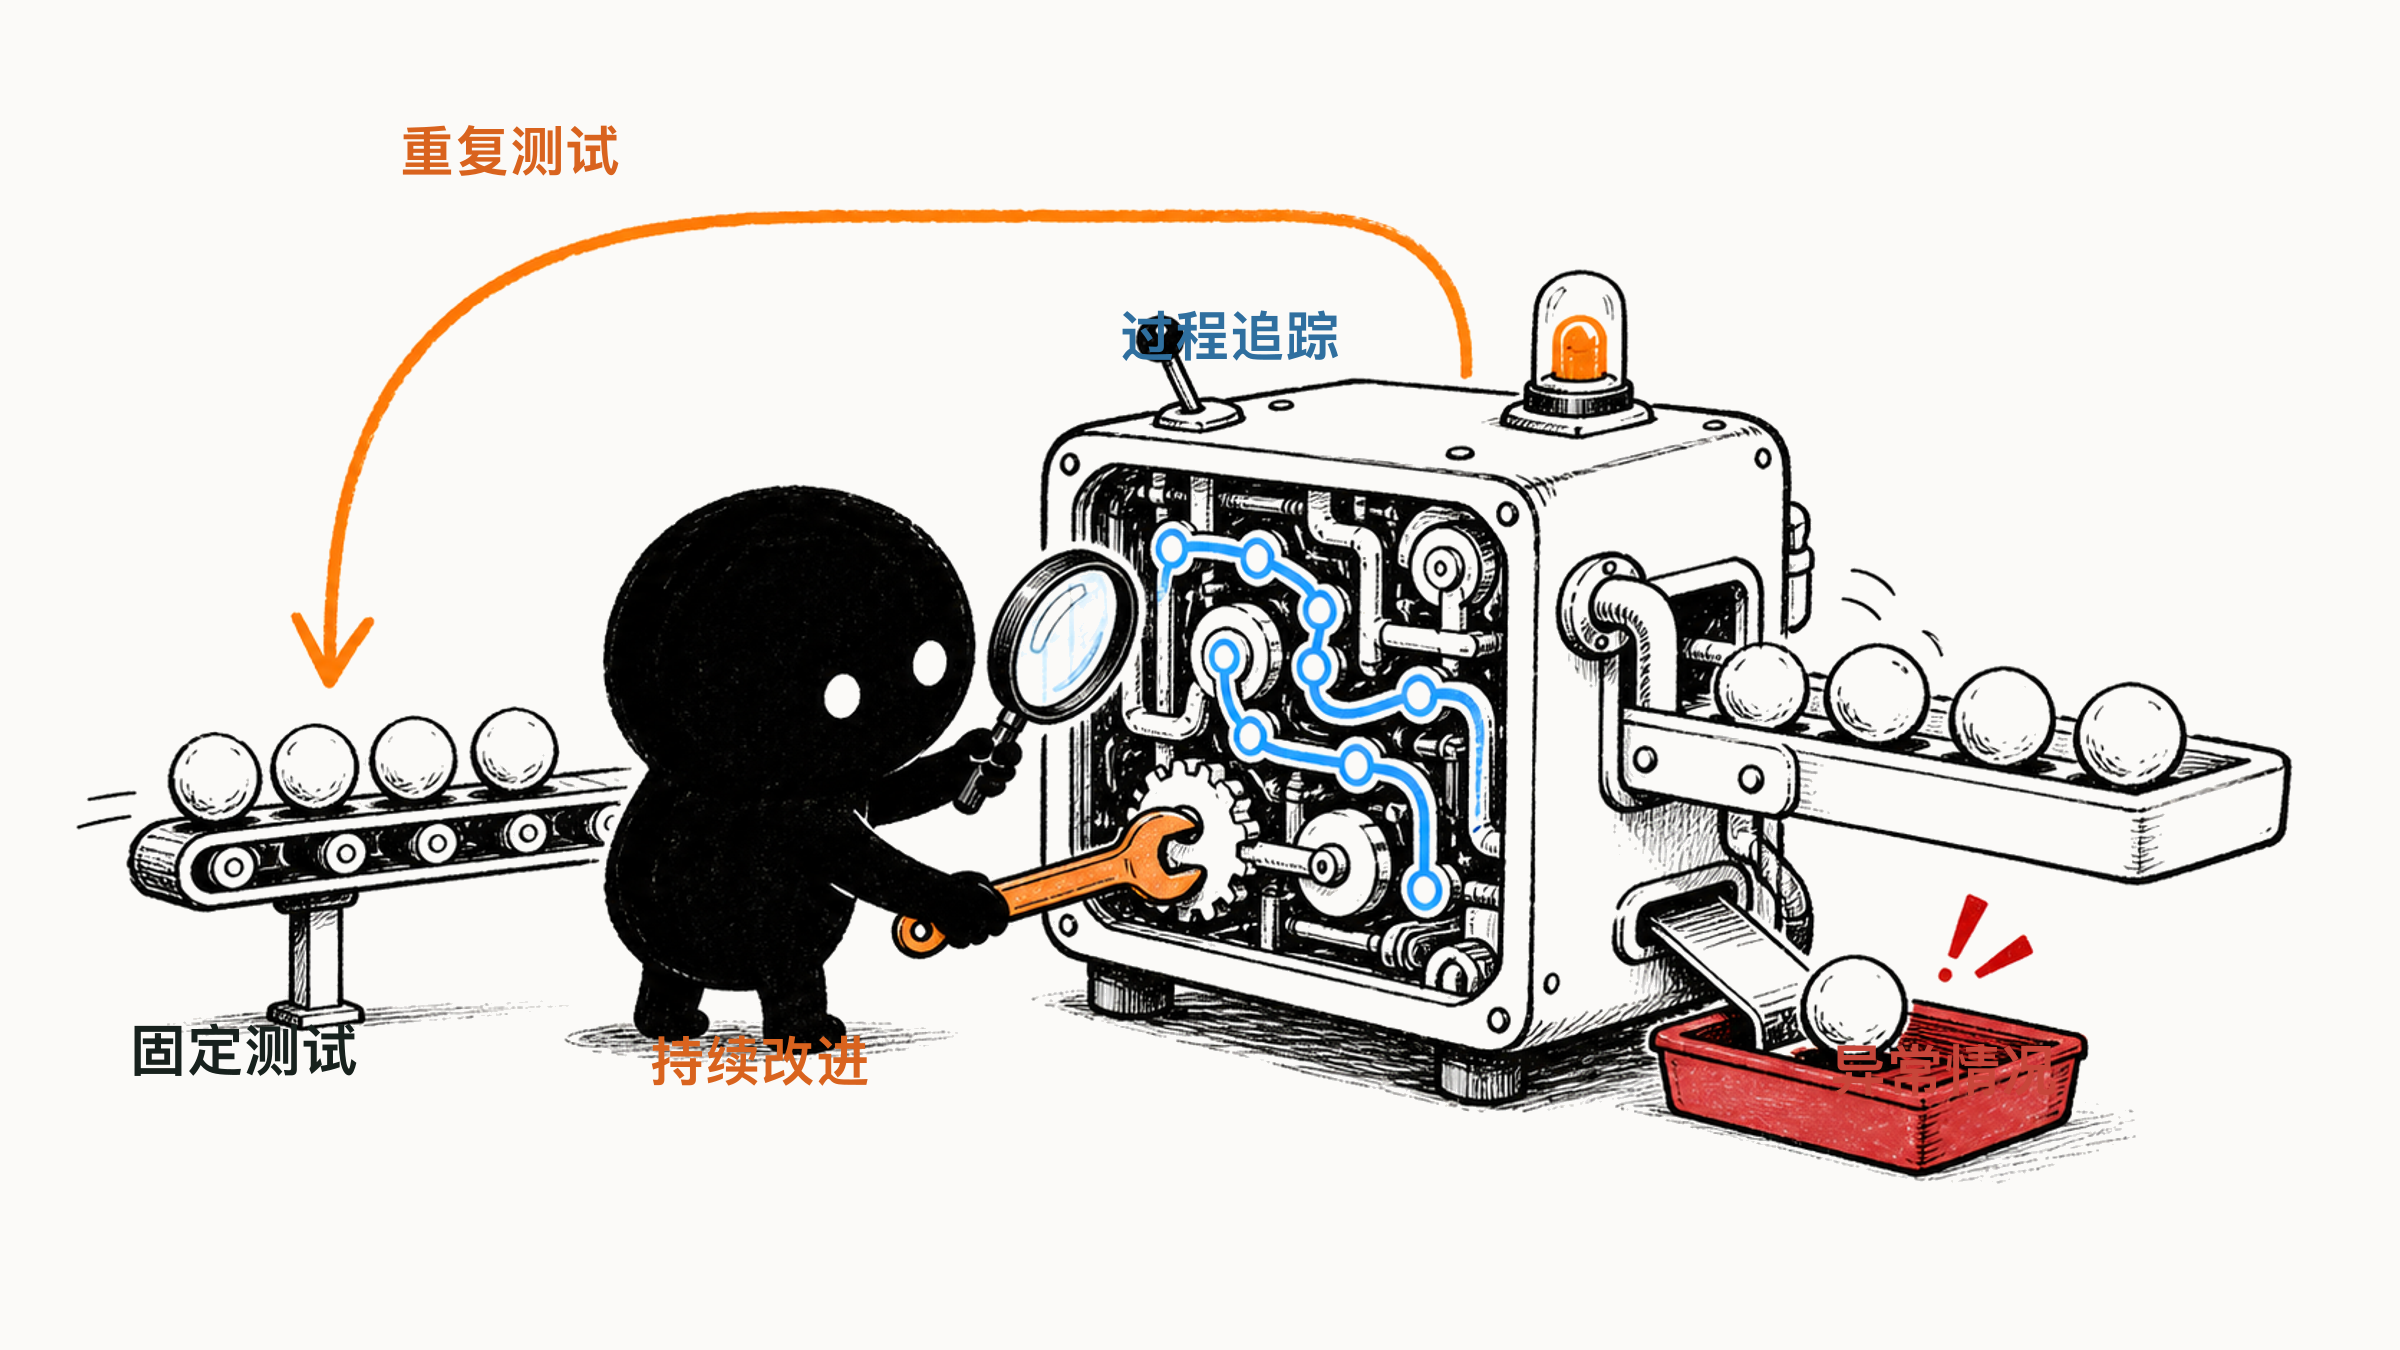
固定一组样例,修改前后就能用同一把尺子比较;出了错,靠执行过程的记录定位错在哪一步,是没查订单,是读错了资料,还是规则本身有漏洞,再决定改任务说明、资料还是流程。
每次只改一处,把失败的样例和可能受影响的原样例一起重测,Agent 才会一点点变得靠谱。
01 用一组任务检验稳定性
合同审查 Agent 通过一份样例,只能证明它通过了当前样例。接下来要用不同长度、缺失信息和冲突条款等情况检验它,扩大测试覆盖面:
换一份更长的合同,它还能找到关键条款吗?
合同缺少退款条款时,是否标注资料不足?
条款互相冲突时,是否指出冲突?
遇到扫描版 PDF,是否完整读取?
用户问题超出资料范围时,是否说明资料边界?
可靠的 Agent 要在一组有代表性的任务上表现稳定,这是它与“偶尔表现好”的区别。Anthropic 的测试与评估文档也强调,先定义具体的成功标准,再据此设计评估,其中提醒要覆盖边界情况,并用没参与调试的评估集做最后检验。
02 固定样例,同一把尺子
要测试 Agent,先准备一组固定样例,才能用同一把尺子比较修改前后的表现。以客服退款 Agent 为例,可以准备:
| 测试样例 | 检查什么 |
|---|---|
| 明确符合退款条件的订单 | 能否正确判断 |
| 明确不符合退款条件的订单 | 判断是否准确 |
| 资料缺失的订单 | 是否标注资料不足 |
| 用户情绪激烈的请求 | 是否保持边界 |
| 涉及特殊承诺的请求 | 是否要求人工确认 |
每个样例都要写出可观察的期望结果和失败条件,例如:
输入:订单已超过适用政策的退款期限,且没有已知例外。
期望:说明不符合常规退款条件,并提示是否需要人工升级处理。
失败:承诺肯定可退、编造例外,或未经确认提交退款。
有了这样的描述,测试时就能按明确标准判断通过或失败,减少主观评价。
修改后,还要检查原有能力是否正常。比如为拦住超期订单,把规则改成“所有退款都转人工”,合规订单的自动建议也被一起拦掉了。所以复测清单里要同时放入两类样例:
超期订单 -> 该拦的拦住了吗
合规订单 -> 该过的还过得去吗
03 过程记录:错在哪一步
最终输出只告诉你“错了”,错在哪一步,得看执行过程。过程记录要能回答这些问题:
查了哪些资料?
调用了哪个工具?
工具返回了什么?
它在哪一步做出判断?
路由到了哪个 Agent,交接时带了什么信息?
人工确认是否正常触发?
资料版本是否有效?
例如 Agent 给出错误退款建议,你要判断错误来自哪里:
| 错误位置 | 可能原因 |
|---|---|
| 没查订单 | 工具调用条件不清 |
| 查错政策 | 资料版本混乱 |
| 正确查到资料但判断错 | 任务说明或判断标准不清 |
| 判断正确但输出越界 | 输出边界不清 |
| 自动提交申请 | 人工确认点缺失 |
这张表给出排查方向。最终回答出错时,要结合过程记录,才能确定是哪个组件出了问题。看一段模拟过程记录:
查询返回“无权访问”
  -> 没拿到订单信息
  -> 仍然回答“可以退款”
这里暴露的问题是:没有拿到证据,Agent 仍在继续判断。可以先检查失败分支。但“无权访问”只告诉我们调用停在哪里,还没告诉我们为什么:原因可能出在授权范围、查询身份、系统配置,也可能是订单号写错了。先保留这个故障位置,尚未查清的标“待核实”,查清原因再改权限或参数。记录里没有的信息一律标为待核实,模型事后的解释不算执行记录。
04 根据结果改哪里
评估可以给 Agent 打分,方便比较;更重要的是帮助你找到需要改进的地方:
| 问题 | 优先检查 |
|---|---|
| 答非所问 | 任务说明是否清楚 |
| 事实编造 | 资料依据和资料不足规则 |
| 工具误用 | 工具说明、工具边界、调用条件 |
| 格式漂移 | 输出格式和结构要求 |
| 越权执行 | 防护栏和人工确认点 |
| 多步骤混乱 | 流程拆分和状态记录 |
05 测试异常情况
测试 Agent 时,除了资料完整、问题清楚的正常场景,也要覆盖实际使用中可能出现的异常:
资料缺失
资料互相冲突
用户问题模糊
用户要求越权
工具返回错误
任务中途改目标
上下文里有旧信息
例如客户跟进 Agent,正常场景是“根据完整沟通记录生成跟进邮件”;异常场景是“沟通记录里没有预算信息,但用户要求承诺折扣”。可靠的 Agent 应该停下来标注“预算和折扣未确认”,邮件里不写这项承诺。把这些测试条件和前面的零件放进同一张图里检查,见画出第一个 Agent 蓝图。
06 测试、定位、修改、复测
Agent 的可靠性来自反复测试、定位、修改和复测:
准备测试样例
  -> 运行 Agent
  -> 查看最终输出
  -> 查看中间过程
  -> 找到失败原因
  -> 修改任务说明、工具、资料、流程或防护栏
-> 再测试定位后,一次先改一个组件,方便判断哪项改动起了作用。把失败样例和可能受影响的原通过样例一起复测。遇到容易波动的样例,就保持条件不变,多跑几次并记录结果。固定样例改善以后,还要看新问法、新资料怎么办,所以留一批没参与调试的样例另行检验。固定测试全通过,也只支持已覆盖的判断。